Идея дать ИИ-агенту доступ к рабочей базе или логам звучит заманчиво: вместо того чтобы вручную искать схему, сверять данные и проверять гипотезы, вы просите помощника сделать это за вас. Но между «прочитать нужные пять строк» и «получить произвольный доступ к инфраструктуре» — огромная дистанция. Ошибка на любом шаге может стоить дороже, чем неправильно сгенерированный код. Поэтому при подключении ИИ к чувствительным ресурсам важно выстроить управляемую границу доступа, а не просто выдать агенту учётные данные.
В этой статье — практический взгляд на то, как организовать такой доступ без потери контроля. Мы не будем обещать «безопасный ИИ вообще» и не станем рекламировать конкретный продукт. Вместо этого разберём риски, шаги настройки, критерии выбора инструментов и типичные ошибки, которые возникают при интеграции ИИ-клиентов с базами, логами и API.
Почему прямой доступ ИИ к инфраструктуре — плохая идея
Когда разработчик выполняет запрос к базе, он опирается на контекст: знает окружение, понимает схему, оценивает последствия. ИИ-агент этого контекста лишён. Ему нужно самостоятельно найти подключение, выбрать базу, разобраться в структуре таблиц, составить запрос и выполнить его. Каждый из этих шагов — точка отказа. Агент может перепутать тестовую и продуктивную среду, сгенерировать деструктивный запрос или случайно прочитать лишние данные.
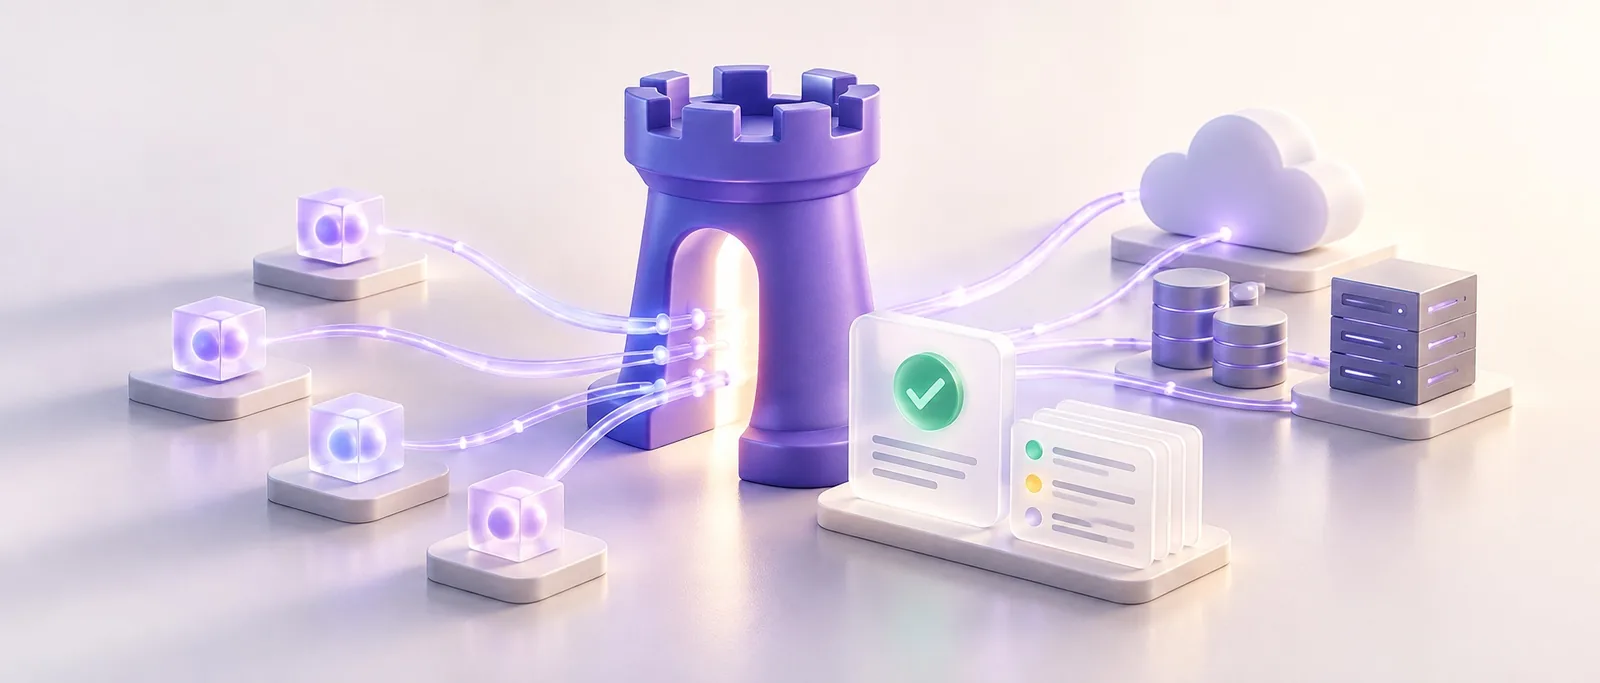
Кроме того, ИИ-модели не всегда предсказуемы: одна и та же формулировка может привести к разным действиям. Без ограничений и журналирования вы рискуете потерять контроль над тем, что именно было сделано и к каким данным получен доступ. Поэтому ключевая задача — не запретить ИИ работать с инфраструктурой, а создать управляемый шлюз, который фиксирует и ограничивает действия.
Как выстроить границу доступа: пошаговый подход
Ниже — последовательность шагов, которая поможет снизить риски при подключении ИИ к базам, логам и другим ресурсам. Она не привязана к конкретному инструменту и подходит для самостоятельной реализации.
- Определите минимально необходимый уровень доступа. Разделите ресурсы на категории: только чтение, чтение с ограничением по строкам, запись с подтверждением. Для каждого типа задач (анализ логов, проверка схемы, обновление тестовых данных) пропишите, какой доступ действительно нужен.
- Используйте отдельные учётные записи и подключения. Не давайте агенту те же права, что и разработчику. Создайте сервисные аккаунты с ограниченными привилегиями и настройте подключения только к тем базам и таблицам, которые необходимы для задачи.
- Внедрите обязательное подтверждение для изменяющих операций. Любой запрос, который модифицирует данные (INSERT, UPDATE, DELETE, DDL), должен требовать явного подтверждения человеком. Это может быть диалоговое окно, уведомление в чате или отдельный шаг в интерфейсе.
- Ведите общий журнал вызовов. Фиксируйте, какой агент, когда и какой запрос выполнил, к какому ресурсу, с каким результатом. Журнал должен быть доступен для аудита и храниться достаточно долго.
- Ограничьте среду выполнения. Если возможно, запускайте агента в изолированном окружении с доступом только к разрешённым ресурсам. Используйте сетевые политики, чтобы предотвратить несанкционированные подключения.
Эти шаги формируют базовый контур безопасности. Но важно понимать, что полностью исключить риски нельзя — можно лишь сделать их управляемыми и наблюдаемыми.
Критерии выбора инструмента для подключения ИИ к инфраструктуре
Если вы рассматриваете готовые решения (шлюзы, MCP-серверы, плагины), обратите внимание на следующие характеристики. Они помогут отсеять небезопасные или неудобные варианты.
- Гранулярность прав. Можно ли настроить доступ на уровне отдельной таблицы, поля или типа операции? Чем точнее настройка, тем ниже риск.
- Механизм подтверждения. Предусмотрено ли обязательное подтверждение для опасных действий? Можно ли настроить правила автоматически?
- Журналирование и аудит. Все ли вызовы логируются? Есть ли возможность экспорта и анализа журналов?
- Локальность и контроль данных. Работает ли решение локально или отправляет данные в облако? Для чувствительной инфраструктуры предпочтительнее локальные или self-hosted варианты.
- Открытость и расширяемость. Если инструмент с открытым исходным кодом, вы можете проверить его безопасность и адаптировать под свои процессы. Закрытые решения требуют больше доверия.
- Поддержка протоколов. Совместим ли инструмент с вашими ИИ-клиентами (например, через MCP или другие стандарты)? Это влияет на удобство интеграции.
Не стоит выбирать решение только по обещаниям «полной безопасности». Реалистичная оценка должна включать анализ того, как инструмент обрабатывает ошибки, какие есть ограничения и как он ведёт себя при попытке несанкционированного доступа.
Типичные ошибки и примеры из практики
Даже при наличии шлюза можно допустить ошибки, которые сведут его пользу на нет. Вот несколько распространённых сценариев.
- Использование одного подключения с широкими правами. Например, агент подключается к продуктивной базе с правами администратора «на всякий случай». Это сводит на нет все ограничения: любая ошибка может привести к катастрофе.
- Отсутствие подтверждения для массовых операций. Агент может сгенерировать запрос, который обновит миллион строк, и выполнить его без предупреждения. Всегда проверяйте, что для таких операций требуется дополнительный шаг.
- Игнорирование журналов. Если журнал ведётся, но никто его не читает, он бесполезен. Настройте регулярный просмотр или автоматические алерты на подозрительные действия.
- Доверие к агенту без проверки схемы. ИИ может неправильно интерпретировать структуру базы и составить запрос, который вернёт неверные данные. Всегда сверяйте результаты с ожидаемыми.
- Отсутствие изоляции окружений. Если тестовая и продуктивная базы доступны через одно подключение, агент может случайно выбрать не ту. Разделяйте подключения и используйте разные учётные записи.
Пример: агент получает задачу «поменяй email тестового пользователя с id=1». Если у него есть доступ к продуктивной базе и нет подтверждения, он может выполнить запрос в неправильном окружении. Шлюз с разделением прав и обязательным подтверждением для UPDATE предотвратит это: агент сможет прочитать данные, но изменение потребует явного одобрения.
Другой пример: анализ логов. Агенту нужно найти ошибки за последний час. Если ему дать доступ ко всем логам без фильтрации, он может прочитать конфиденциальные данные. Ограничение по полям и строкам (например, только уровень ERROR и только за последний час) снижает риск утечки.
Что важно помнить
Подключение ИИ к инфраструктуре — это не разовое действие, а процесс. Начните с малого: дайте агенту доступ только на чтение к тестовой базе, настройте журналирование и подтверждение для изменений. Постепенно расширяйте права, если это действительно необходимо и риск оправдан. Регулярно пересматривайте политики доступа и проверяйте журналы.
Не полагайтесь на заверения о «безопасном ИИ» — проверяйте, как инструмент обрабатывает граничные случаи, какие у него ограничения и как он ведёт себя при попытке обойти правила. Открытый исходный код и локальная работа могут дать больше контроля, но требуют экспертизы для настройки.
И главное: ИИ-агент — это инструмент, а не замена разработчику. Ответственность за изменения остаётся на человеке. Чем прозрачнее граница доступа и чем понятнее журнал действий, тем проще сохранить контроль и избежать дорогих ошибок.