Глубокое обучение в обработке естественного языка (NLP) часто кажется сложным: много терминов, библиотек и неочевидных решений. Но если разобраться, классификация текста — одна из самых доступных задач для старта. В этой статье мы не будем углубляться в теорию, а сразу перейдём к практике: соберём двухслойную нейронную сеть, которая относит текст к одной из категорий. Вы увидите конкретные шаги, критерии выбора и ошибки, которые допускают новички.
Подготовка данных: что важно учесть
Прежде чем строить сеть, нужно привести текст в машиночитаемый вид. Начните с очистки: уберите HTML-теги, лишние пробелы, приведите к нижнему регистру. Затем токенизация — разбейте текст на слова или подслова. Для простых задач хватит разбиения по пробелам, но лучше использовать готовые токенизаторы (например, из библиотек TensorFlow/Keras или PyTorch).
После токенизации преобразуйте последовательности в числовые векторы. Два популярных подхода: Bag-of-Words (мешок слов) с последующей нормализацией или Embedding-слой, который обучается вместе с сетью. Для двухслойной сети классификации текста чаще берут Embedding + усреднение или Embedding + рекуррентный слой. Но мы рассмотрим более простой вариант: эмбеддинги фиксированной длины с последующим полносвязным слоем.
Разбейте данные на обучающую, валидационную и тестовую выборки в пропорции 70/15/15 или 80/10/10. Убедитесь, что классы сбалансированы — если нет, используйте взвешивание классов или аугментацию. Типичная ошибка — забыть про валидацию и настраивать модель на тесте, что даёт ложное чувство качества.
Архитектура двухслойной сети: простота против переобучения
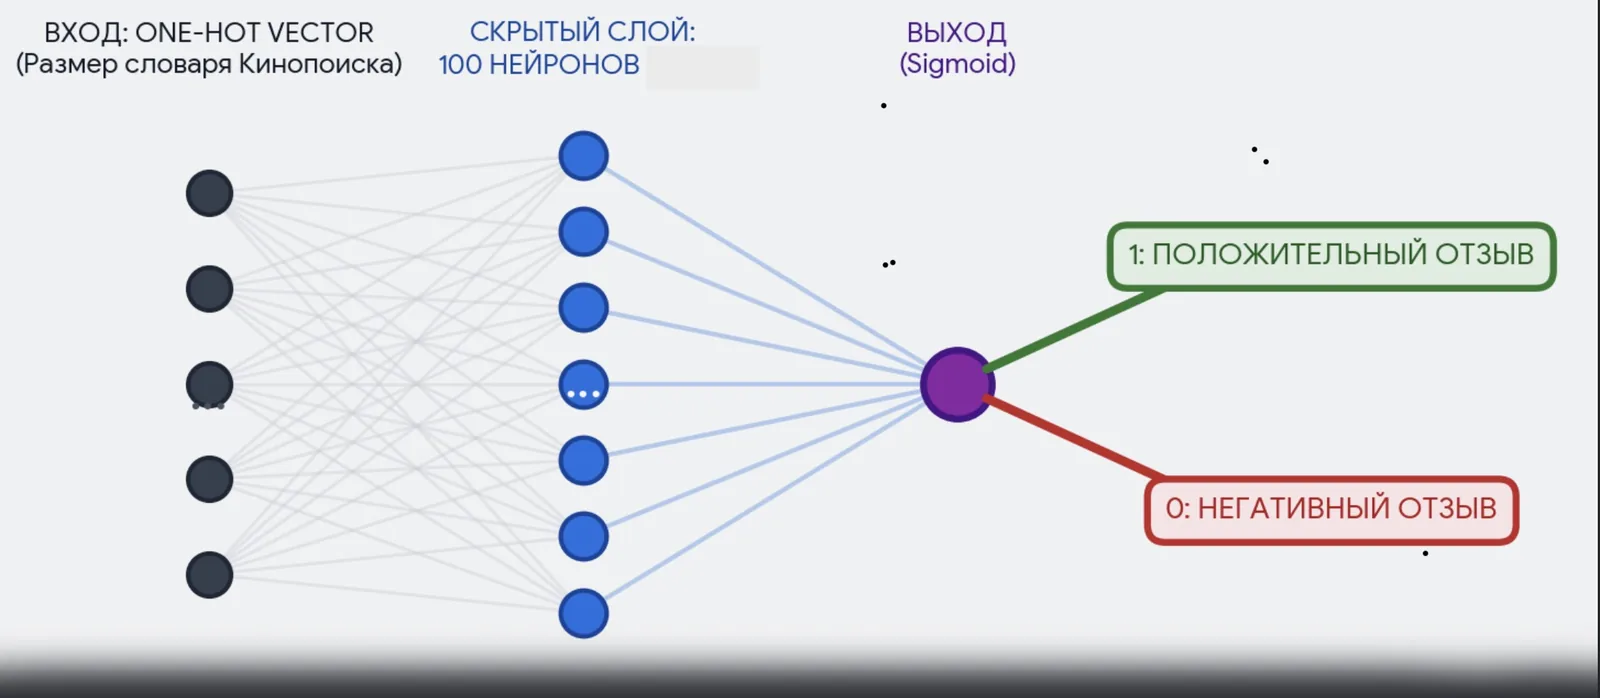
Двухслойная сеть означает, что после входного слоя (эмбеддингов) идёт один скрытый слой, а затем выходной. Например: Embedding (размерность 100) → GlobalAveragePooling1D → Dense (64 нейрона, активация ReLU) → Dense (число классов, активация Softmax). Такая архитектура уже способна улавливать базовые закономерности в тексте.
Ключевые критерии выбора:
- Размер эмбеддингов — от 50 до 300. Меньше — быстрее, но может не хватить выразительности; больше — риск переобучения на малых данных.
- Число нейронов в скрытом слое — начните с 32–128. Слишком много — сеть запомнит шум; слишком мало — не выучит закономерности.
- Функция потерь — для многоклассовой классификации используйте категориальную кросс-энтропию, для бинарной — бинарную.
- Регуляризация — добавьте Dropout (0.2–0.5) после скрытого слоя, чтобы снизить переобучение.
Не гонитесь за глубиной: для многих задач классификации текста двух слоёв достаточно. Главное — правильно подобрать гиперпараметры и не забыть про early stopping.
Обучение и оценка: шаг за шагом
Разделите данные на батчи (например, по 32 или 64 примера). Используйте оптимизатор Adam с learning rate 0.001 — это хорошая отправная точка. Обучайте модель 10–20 эпох, отслеживая потерю и точность на валидации. Если валидационная потеря перестала падать, а train loss продолжает снижаться — это признак переобучения. В таком случае уменьшите число нейронов, добавьте Dropout или сократите число эпох.
После обучения оцените модель на тестовой выборке. Смотрите не только на accuracy, но и на precision, recall и F1-меру по каждому классу. Если один класс явно хуже, проверьте, достаточно ли примеров и не путает ли модель его с другим.
Типичные ошибки на этом этапе:
- Использование тестовой выборки для настройки гиперпараметров (правильно — только валидация).
- Отсутствие нормализации входных данных (например, эмбеддинги без масштабирования).
- Слишком большой learning rate — модель не сходится, или слишком маленький — обучение затягивается.
- Игнорирование дисбаланса классов — модель может предсказывать только мажоритарный класс.
Практический пример и что делать дальше
Предположим, вы классифицируете отзывы на позитивные и негативные. После обучения двухслойной сети вы получили accuracy 0.85 на валидации. Это неплохой старт. Попробуйте улучшить результат: замените усреднение эмбеддингов на слой LSTM или GRU, добавьте предобученные эмбеддинги (например, GloVe или FastText), если у вас мало данных. Но помните: усложнение не всегда даёт прирост — сначала убедитесь, что простые модели работают стабильно.
Ещё один важный шаг — интерпретация. Посмотрите, какие слова вносят наибольший вклад в предсказание, используя методы вроде анализа весов или attention. Это поможет понять, не выучила ли сеть случайные артефакты.
Наконец, сохраните модель и напишите функцию для предсказания на новых текстах. Проверьте её на нескольких примерах вручную — так вы поймёте, где модель ошибается и какие данные стоит добавить.
Двухслойная сеть — это не конечная точка, а хорошая база. Освоив её, вы сможете перейти к более сложным архитектурам, не увязнув в деталях. Главное — практика и внимание к качеству данных.