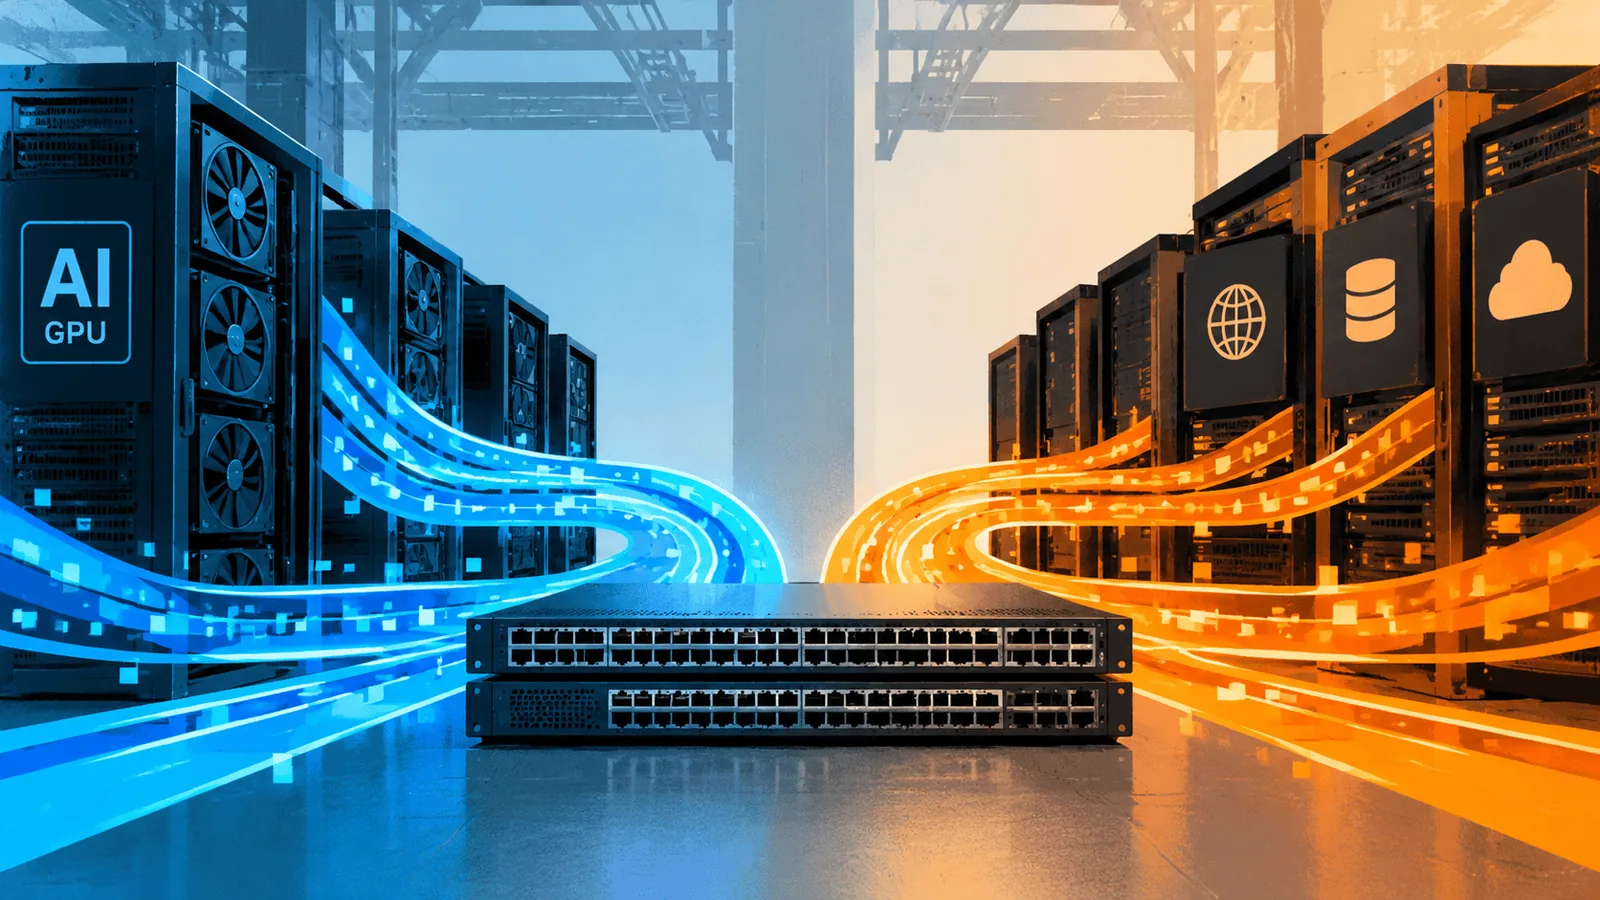
Современный центр обработки данных всё чаще становится площадкой для двух принципиально разных типов нагрузки: кластеров GPU, которые обучают и обслуживают ИИ-модели, и традиционных веб-приложений, баз данных и корпоративных сервисов. На первый взгляд, инфраструктура одна — значит, можно всё разместить вместе и сэкономить. На практике такое соседство приводит к перегрузкам сети, простоям дорогих ускорителей и неоправданным затратам. Разберёмся, почему так происходит и какие шаги помогут выстроить сеть без конфликтов.
Чем отличаются требования ИИ-нагрузок и традиционных приложений
Традиционные приложения обычно чувствительны к задержкам, но не создают постоянного гигантского трафика. Веб-сервер обменивается небольшими запросами и ответами, база данных — короткими транзакциями. Сеть должна быть надёжной и предсказуемой, но пиковые нагрузки редко длятся долго. ИИ-кластеры ведут себя иначе: при обучении модели тысячи GPU постоянно обмениваются градиентами и промежуточными данными. Объём трафика огромен, а любая задержка или потеря пакета замедляет весь кластер. Простой одного ускорителя стоит дорого, поэтому сеть для ИИ должна обеспечивать максимальную пропускную способность и минимальные потери.
Кроме того, ИИ-нагрузки часто работают пакетно: несколько часов или дней интенсивного обучения, затем пауза. Традиционные сервисы, наоборот, требуют стабильного круглосуточного отклика. Если объединить их в одной сети без разделения, всплеск трафика от обучения может «задушить» веб-приложения, а фоновая активность сервисов — внести непредсказуемость в работу GPU-кластера.
Типичные ошибки при объединении нагрузок в одной инфраструктуре
- Единая сеть без изоляции. Попытка пустить трафик обучения и пользовательские запросы через одни и те же коммутаторы и каналы. В результате пики ИИ-трафика вызывают задержки и потери пакетов для критичных сервисов.
- Экономия на пропускной способности. Желание использовать существующую сеть 10–25 Гбит/с для GPU-кластера. Для современных ускорителей этого недостаточно, и кластер простаивает в ожидании данных.
- Игнорирование профиля трафика. Проектирование сети исходя из средних значений, без учёта пиковых всплесков от синхронизации градиентов. Это приводит к перегрузкам в моменты, когда все GPU обмениваются данными одновременно.
- Отсутствие мониторинга на уровне приложений. Сетевые метрики вроде утилизации портов не показывают, что именно тормозит обучение. Без сквозного мониторинга сложно найти узкое место.
Пример: компания разместила кластер из 64 GPU и несколько веб-сервисов в одной стойке, подключённой к общему коммутатору. Во время обучения модели веб-приложения начали отвечать с задержкой в несколько секунд, а обучение замедлилось из-за потерь пакетов. Разделение трафика на отдельные VLAN и выделение GPU-кластеру собственных uplink-каналов решило проблему, но потребовало дополнительных затрат на коммутаторы.
Как выстроить сетевую фабрику для двух типов нагрузки
Первый шаг — разделить трафик логически и физически. Для ИИ-кластера выделите отдельный сегмент сети с высокой пропускной способностью (например, 100–400 Гбит/с на порт) и низкой задержкой. Традиционные приложения могут остаться на существующей инфраструктуре с избыточностью и приоритизацией трафика. Если бюджет ограничен, используйте виртуальные сети и QoS, чтобы ограничить влияние ИИ-трафика на сервисы, но помните, что это временное решение.
Второй шаг — выбрать топологию, которая масштабируется под рост кластера. Для GPU-нагрузок часто используют фабрику с неблокирующей архитектурой (например, leaf-spine), где каждый ускоритель получает равный доступ к сети. Важно, чтобы пропускная способность между любыми двумя GPU была достаточной для синхронизации без узких мест. Третий шаг — настроить мониторинг и управление политиками. Собирайте метрики не только с коммутаторов, но и с приложений: время ожидания данных, количество повторных передач, утилизацию GPU. Это поможет вовремя заметить деградацию.
Критерии выбора архитектуры и практические рекомендации
При выборе решения ориентируйтесь на профиль нагрузки. Если ИИ-кластер небольшой (до 8–16 GPU) и используется периодически, можно обойтись выделенным коммутатором и прямым подключением к хранилищу. Для крупных кластеров (сотни GPU) нужна полноценная фабрика с поддержкой RDMA и возможностью изолировать трафик. Оцените, насколько критичен простой ускорителей: если обучение модели стоит дорого, экономия на сети обернётся потерями.
Типичная ошибка — пытаться сэкономить на коммутаторах, покупая модели без нужной буферизации. Для ИИ-трафика важны глубокие буферы и поддержка приоритетов. Также не стоит размещать GPU-кластер и критичные сервисы в одной зоне отказа: сбой коммутатора может остановить и обучение, и пользовательские приложения. Предусмотрите резервирование хотя бы на уровне uplink-каналов.
Наконец, начните с пилотного проекта: выделите небольшой сегмент для ИИ-нагрузок, измерьте реальные требования к сети и только потом масштабируйте. Так вы избежите капитальных затрат на инфраструктуру, которая не подходит под ваши задачи. Помните, что универсального решения нет — выбор зависит от того, какие приложения вы запускаете и насколько дорог простой для бизнеса.