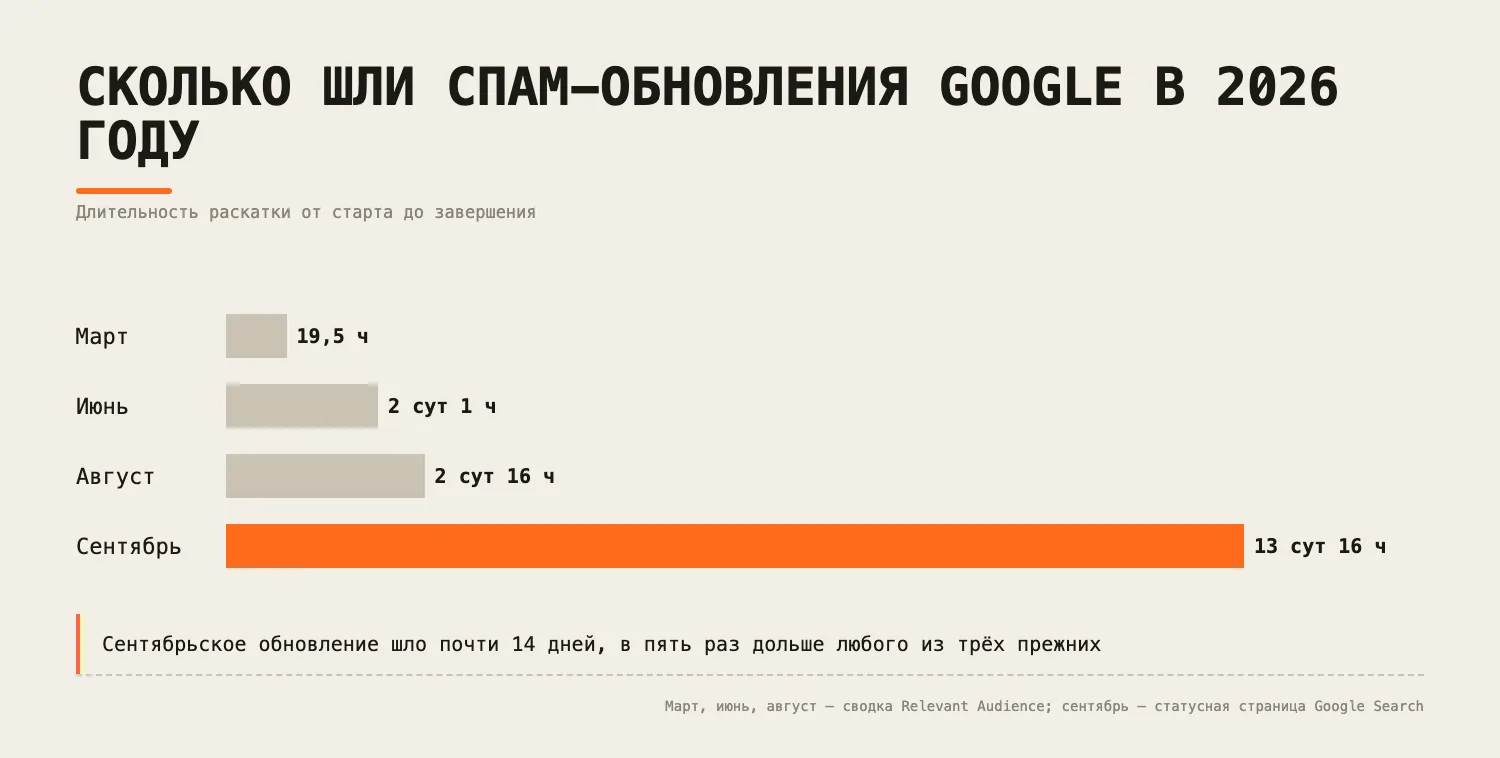
Осеннее обновление Google против спама длилось почти две недели и затронуло все языки. Оно стало заметным событием, потому что впервые так явно сместило фокус на массово сгенерированный контент. Если часть страниц вашего сайта написана нейросетью или собрана по шаблону, стоит проверить, не выглядят ли они однотипными. Google не публикует порог похожести, после которого страницы считаются почти одинаковыми, поэтому решение придётся принимать самостоятельно. Ниже — практический подход: как найти такие страницы, какие метрики использовать и что делать с результатами.
Почему Google не называет порог и что это значит для вас
Поисковики принципиально не раскрывают точные значения алгоритмических порогов. Это защищает от манипуляций и позволяет обновлять правила без публичных обещаний. Для владельца сайта это означает: нельзя ориентироваться на «магическое число» вроде 80% или 90% схожести. Вместо этого нужно построить собственную систему проверки, которая будет консервативной и объяснимой. Ваша задача — не угадать порог Google, а найти страницы, которые с высокой вероятностью выглядят как массовое производство, и либо переписать их, либо объединить, либо закрыть от индексации.
Как найти почти одинаковые страницы: пошаговый подход
Самый доступный способ — сравнить тексты страниц между собой. Не нужно сложных ML-моделей: начните с простых метрик, которые дают понятный результат.
- Шаг 1. Соберите тексты. Выгрузите содержимое страниц из CMS или через парсер. Уберите HTML-теги, меню, футер и служебные блоки. Оставьте только основной контент.
- Шаг 2. Нормализуйте текст. Приведите к нижнему регистру, удалите пунктуацию и лишние пробелы. Для русского языка можно не делать стемминг на первом этапе — это усложнит интерпретацию.
- Шаг 3. Посчитайте похожесть. Используйте коэффициент Жаккара по шинглам (например, по 3–5 словам) или косинусное сходство по TF-IDF. Оба метода дают число от 0 до 1, которое легко порогово отфильтровать.
- Шаг 4. Выберите порог. Начните с 0,7–0,8 для шинглов. Если страниц много, отсортируйте пары по убыванию похожести и вручную просмотрите топ-20. Так вы поймёте, где начинается «почти одинаково» именно для вашего контента.
- Шаг 5. Сохраните результаты. Выгрузите пары URL и значения похожести в таблицу. Это база для дальнейших решений.
Пример на Python: возьмите библиотеку datasketch для MinHash или напишите простой цикл с difflib.SequenceMatcher. Для сайта до 1000 страниц хватит и попарного сравнения. Для больших сайтов используйте MinHash LSH, чтобы не сравнивать каждую страницу с каждой.
Критерии выбора порога и типичные ошибки
Порог похожести — это не истина в последней инстанции, а инструмент приоритизации. Ориентируйтесь на три критерия.
- Критерий 1. Объём текста. Короткие страницы (до 300 слов) легче стать почти одинаковыми. Для них порог можно снизить до 0,6, но проверяйте вручную.
- Критерий 2. Назначение страницы. Карточки товаров с одинаковым описанием и разные города в заголовке — классические кандидаты на спам. Страницы с уникальными данными (цены, характеристики, отзывы) реже выглядят шаблонными.
- Критерий 3. Доля ИИ-текста. Если вы генерировали описания нейросетью, сравните их между собой. Часто они отличаются лишь синонимами, и шинглы это покажут.
Типичные ошибки: сравнивать тексты без очистки от меню и футера (получите ложные совпадения); выбирать порог «на глаз» без просмотра примеров; игнорировать страницы с малым объёмом текста; удалять страницы сразу, не проверив, есть ли на них трафик или ссылки. Ещё одна ошибка — пытаться привести все страницы к уникальности 100%. Это трудозатратно и не всегда нужно: иногда лучше объединить несколько почти одинаковых страниц в одну с более полным ответом.
Что делать с найденными страницами
После того как вы получили список пар с высокой похожестью, действуйте по ситуации. Если страницы дублируют друг друга и не несут разной ценности, настройте 301-редирект на основную версию. Если страницы нужны для разных запросов, перепишите их так, чтобы каждая содержала уникальные факты, примеры или данные. Если переписать невозможно, закройте их от индексации через noindex или удалите. Для страниц с ИИ-текстом добавьте проверяемые детали: цифры, даты, ссылки на источники, локальную специфику. Это снижает риск, что алгоритм посчитает контент массовым производством.
Важно не превращать проверку в разовую акцию. Обновления Google выходят регулярно, и пороги могут меняться. Сделайте скрипт частью рутины: запускайте его после каждой крупной публикации или раз в месяц. Сохраняйте историю похожести, чтобы видеть, не начинают ли новые страницы дублировать старые. Такой мониторинг занимает меньше времени, чем разбор последствий после очередного обновления.