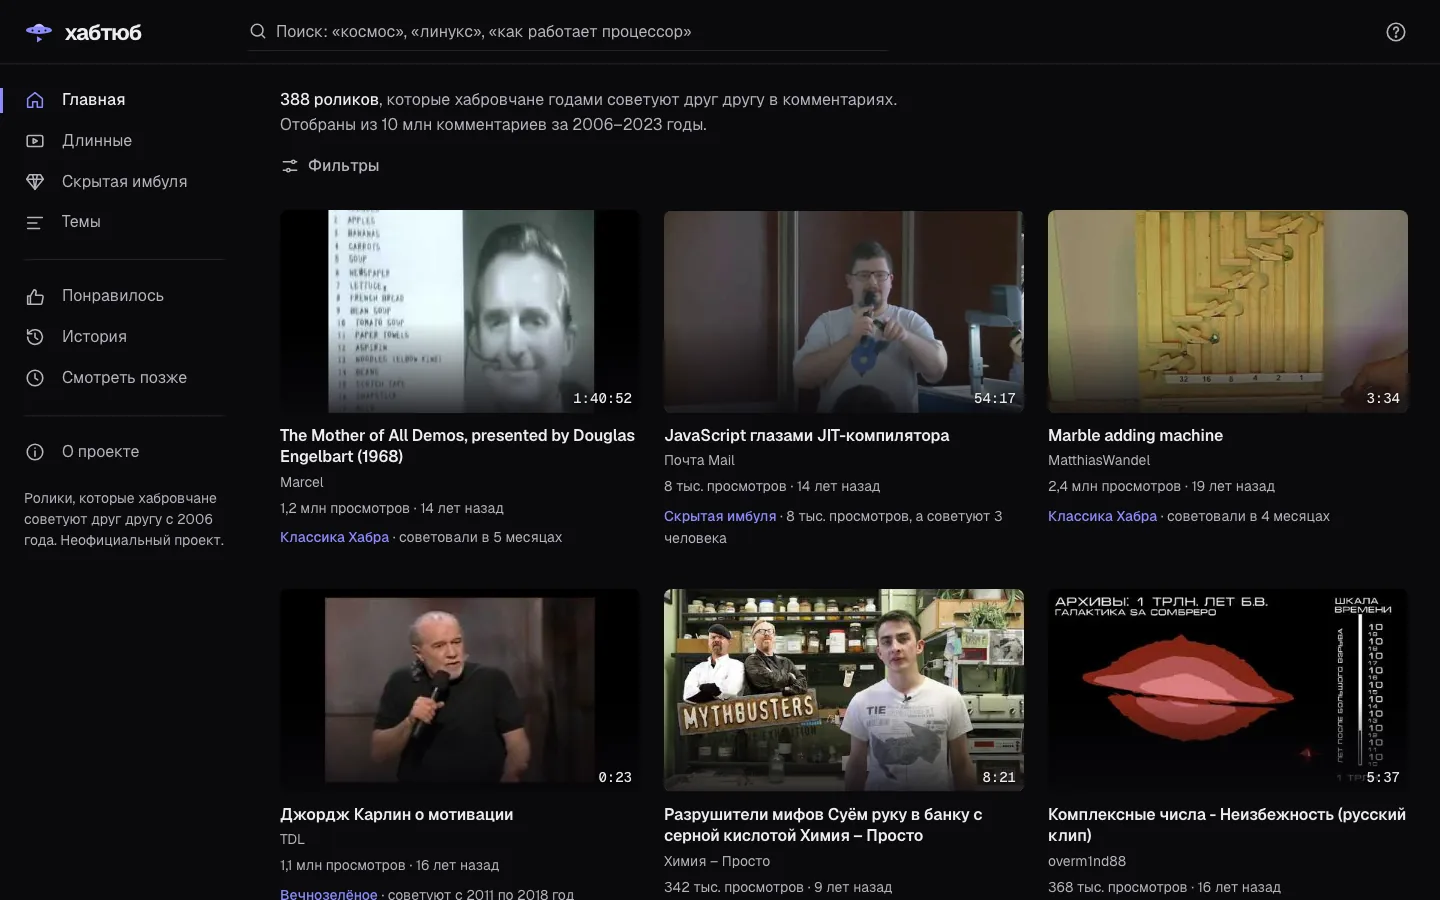
История про то, как Андрей Карпатый собрал подборку видео из многолетних комментариев Hacker News, а затем энтузиаст повторил это для русскоязычного сообщества, выглядит как красивый вирусный кейс. И это действительно хороший пример: вместо очередной «нейросети для всего» здесь решается конкретная задача — найти в хаосе обсуждений то, что люди годами советуют друг другу, и превратить это в удобный каталог. Но если вы захотите повторить такой проект, полезно смотреть не на заголовок «сделал за два часа», а на структуру работы. Ниже — практичный разбор подхода: что именно делается, в каком порядке, где узкие места и какие ошибки чаще всего ломают подобные инициативы.
Что на самом деле представляет собой такой проект
На входе — большой массив комментариев сообщества. На выходе — структурированная подборка видео: ссылки, короткие описания, возможно, теги и поиск по смыслу. Между этими точками есть несколько слоёв работы. Первый — получение данных: публичный архив комментариев, выгрузка, очистка от мусора. Второй — извлечение ссылок на видео и связанного с ними контекста: о чём был комментарий, почему ссылку советуют, к какой теме она относится. Третий — дедупликация: одна и та же ссылка может встречаться десятки раз в разных обсуждениях. Четвёртый — генерация описаний и тегов. Пятый — интерфейс: поиск, фильтры, навигация.
Важно сразу разделить «демо» и «продукт». Демо — это скрипт, который вытащил ссылки и сложил в таблицу. Продукт — это когда по подборке можно осмысленно искать, описания не врут, а реклама и спам отфильтрованы. Разница между ними — не в модели, а в инженерной дисциплине.
Пошаговый план: от архива до каталога
Если вы хотите повторить подобный проект на своём сообществе, начните с ограничения масштаба. Не берите «все комментарии за десять лет» — возьмите один раздел или один год и доведите пайплайн до конца. Дальше расширять проще, чем чинить архитектуру, собранную вслепую.
- Шаг 1. Определите источник и правила. Проверьте, разрешает ли площадка выгрузку и повторное использование контента. Публичная доступность не равна праву на перепубликацию.
- Шаг 2. Соберите сырые данные. Сохраните комментарии с метаданными: дата, ветка, автор (или хеш автора), текст. Не парсите «на лету» в момент анализа — сначала локальная копия.
- Шаг 3. Извлеките ссылки на видео. Регулярные выражения по доменам видеоплатформ плюс нормализация URL: убрать utm-метки, привести к каноническому виду, иначе дедупликация не сработает.
- Шаг 4. Соберите контекст. Для каждой ссылки сохраните фрагмент комментария вокруг неё — он понадобится и для описания, и для оценки релевантности.
- Шаг 5. Отфильтруйте шум. Реклама, самореклама, битые ссылки, ролики не по теме. Простые правила (чёрные списки домов, повторяющиеся шаблоны текста) закрывают большую часть мусора до всякого ИИ.
- Шаг 6. Сгенерируйте описания. Модель пишет краткое резюме на основе контекста комментария, а не «из головы». Обязательно проверьте выборку вручную.
- Шаг 7. Добавьте поиск. Семантический поиск по описаниям и тегам полезнее, чем поиск по точному совпадению слов.
- Шаг 8. Соберите минимальный интерфейс. Список, фильтры по темам, поисковая строка. Без регистрации — это снижает трение и соответствует духу таких проектов.
Критерии качества и типичные ошибки
Главный критерий качества такого каталога — не количество видео, а доля полезных. Тысяча ссылок, половина из которых ведёт на удалённые ролики или рекламные обзоры, хуже, чем двести проверенных. Второй критерий — честность описаний: если резюме обещает «разбор архитектуры», а в видео десятиминутная презентация продукта, доверие к подборке падает быстро. Третий — воспроизводимость: пайплайн должен обновляться по расписанию, иначе каталог устаревает за пару месяцев.
Типичные ошибки выглядят предсказуемо. Авторы недооценивают очистку данных и тратят недели на модель, которая работает поверх грязного массива. Дедупликацию делают по сырым URL и получают дубли с разными метками. Описания генерируют без контекста, и модель придумывает содержание ролика. Фильтрацию рекламы откладывают «на потом», а потом стыдятся показывать результат. И наконец, заявляют сроки вроде «два часа», хотя два часа — это время на прототип, а не на работающий сервис.
Отдельно про «два часа». В историях такого жанра это обычно время, за которое автор, уже имея опыт и заготовки, собрал демонстрационную версию. Для человека с нуля реалистичный горизонт — несколько вечеров на прототип и ещё столько же на доведение до состояния, которое не стыдно показать. Это не обесценивает кейс: наоборот, он показывает, что порог входа снизился. Но снизился он для тех, кто готов разбираться с данными, а не только нажимать кнопку.
Кому и зачем это нужно
Подобные проекты полезны в трёх сценариях. Первый — личная база знаний: вы собираете рекомендации из сообщества, которое вам близко, и получаете тематическую библиотеку. Второй — исследование: анализ того, какие темы и какие источники сообщество ценит на самом деле, а не по официальным дайджестам. Третий — портфолио: проект показывает навыки работы с данными, текстом и интерфейсом одновременно, что для digital-специальностей убедительнее очередного туториального клона.
Если решите повторить, начните с малого и относитесь к проекту как к инженерной задаче, а не к хайпу. Ограничьте данные, постройте пайплайн, проверьте качество на выборке, и только потом масштабируйте. Тогда подборка из комментариев будет не вирусным заголовком, а рабочим инструментом, которым действительно хочется пользоваться.