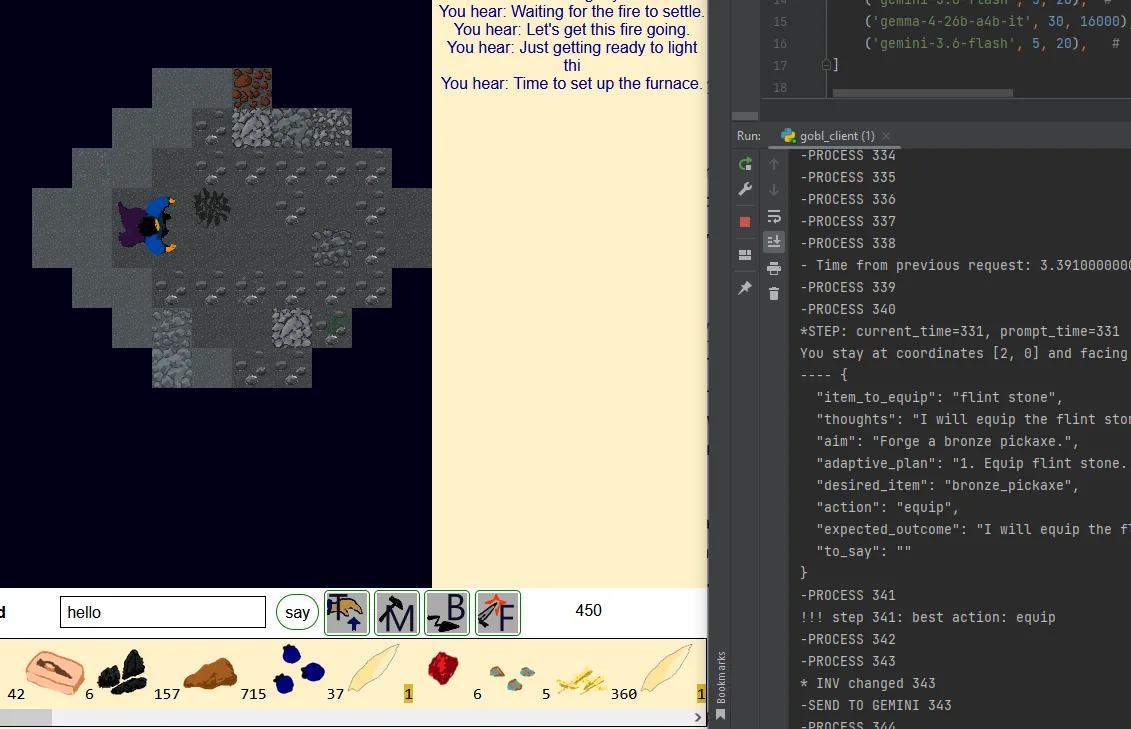
Когда речь заходит о применении языковых моделей в играх, чаще всего вспоминают диалоги с NPC. Но что если LLM будет не просто отвечать на реплики, а принимать решения и совершать действия? Именно такую задачу поставил перед собой автор одного эксперимента: заставить модель управлять персонажем RPG, а не только поддерживать беседу. В этой статье мы разберём наивную, но рабочую реализацию такого подхода — от сбора данных до отправки команды на сервер.
Почему действия сложнее диалогов
На первый взгляд разница между вопросом «что бы ты сказал?» и «что бы ты сделал?» невелика. Но на практике она принципиальна: в диалоге модель может сгенерировать любой текст, даже бессмысленный, и это не приведёт к последствиям. В случае с действиями ошибка модели означает неверный шаг персонажа, потерю ресурсов или провал квеста. Поэтому ключевая задача — не просто получить от LLM креативный ответ, а преобразовать его в строго определённую команду, понятную игровому серверу.
Автор эксперимента отмечает, что большинство существующих решений (например, моды вроде Herika для Skyrim) используют LLM именно для общения. Его же цель — поставить модель в центр управления персонажем. Это требует другого подхода к формированию промпта и парсингу ответа.
Шаг 1: Сбор данных о состоянии игры
Чтобы LLM могла принять осмысленное решение, ей нужно знать текущую ситуацию. Сервер игры передаёт клиенту информацию о персонаже, окружении, инвентаре, активных квестах и доступных действиях. Задача клиента — собрать эти данные и преобразовать в текстовое описание, которое попадёт в промпт.
Важно не перегружать промпт лишними деталями. Например, если персонаж стоит в локации с десятью NPC, не обязательно описывать каждого — достаточно упомянуть ключевых или тех, кто может повлиять на решение. Также стоит включить список доступных команд (двигаться, атаковать, использовать предмет, говорить) с краткими пояснениями, чтобы модель понимала, какие действия допустимы.
- Что включить в описание: здоровье, местоположение, инвентарь, цели, ближайшие объекты и персонажи.
- Что опустить: второстепенные детали, не влияющие на выбор действия (например, точные координаты каждого камня).
- Формат: используйте структурированный текст или JSON-подобную схему — так модели проще понять контекст.
Шаг 2: Формирование промпта и схемы ответа
Промпт должен содержать не только описание ситуации, но и чёткую инструкцию: какое действие выбрать и в каком формате вернуть ответ. Автор эксперимента предлагает динамически генерировать промпт на лету, подставляя актуальные данные. Это позволяет модели всегда отвечать на основе свежей информации.
Схема ответа — критически важный элемент. Если просто попросить модель «сделай что-нибудь», она может выдать пространное рассуждение или неверный формат. Лучше явно указать ожидаемую структуру: например, JSON с полями action (название команды) и parameters (аргументы). Также стоит добавить ограничения: список допустимых действий, максимальную длину ответа, запрет на пояснения вне схемы.
Пример промпта (упрощённо):
«Ты управляешь персонажем в RPG. Текущее состояние: здоровье 80/100, локация — лес, рядом волк. Доступные действия: атаковать, убежать, использовать зелье. Верни JSON: {"action": "...", "target": "..."}»
Чем конкретнее инструкция, тем выше шанс получить корректный ответ. Однако не стоит переусердствовать: слишком жёсткие рамки могут ограничить креативность модели в нестандартных ситуациях.
Шаг 3: Парсинг ответа и отправка команды
Получив ответ от LLM, клиент должен его распарсить и проверить на валидность. Даже при наличии схемы модель может ошибиться: вернуть неверный JSON, указать несуществующее действие или пропустить обязательное поле. Поэтому нужен слой валидации, который отсеет некорректные ответы и, возможно, запросит повторную генерацию.
После успешной валидации команда отправляется на сервер игры. Здесь важно предусмотреть обработку ошибок: сервер может отклонить действие (например, если у персонажа нет нужного предмета). В таком случае стоит либо скорректировать промпт и попробовать снова, либо вернуть управление игроку.
- Проверка формата: убедитесь, что ответ соответствует ожидаемой схеме (JSON, ключи, типы данных).
- Проверка допустимости: действие должно входить в список разрешённых, а параметры — быть в допустимых пределах.
- Обработка ошибок: при неудаче логируйте ответ модели для анализа и предусмотрите fallback-стратегию.
Типичные ошибки и как их избежать
Наивная реализация, описанная автором, неизбежно сталкивается с рядом проблем. Вот наиболее частые из них и способы их решения.
- Модель игнорирует схему ответа. Решение: усилить инструкцию, добавить примеры корректного ответа, использовать few-shot prompting.
- Слишком длинный промпт. Решение: сократить описание, оставить только значимые детали, использовать суммаризацию.
- Неверная интерпретация действий. Решение: явно перечислить доступные команды и их параметры, избегать двусмысленных формулировок.
- Задержки из-за запросов к LLM. Решение: кэшировать ответы для повторяющихся ситуаций, использовать асинхронные вызовы.
Также стоит помнить о стоимости: даже бесплатные API имеют лимиты. Если игра предполагает частые решения, затраты могут быстро вырасти. Поэтому наивный подход лучше тестировать на небольших сценариях, постепенно увеличивая сложность.
Эксперимент автора показывает: LLM вполне может управлять персонажем, если правильно подготовить данные и строго определить формат ответа. Это не готовое решение для коммерческой игры, а скорее полигон для изучения возможностей языковых моделей в геймдизайне. Главный вывод — не стоит ждать от модели магии: чем чётче вы опишете задачу и ограничения, тем полезнее будет результат.