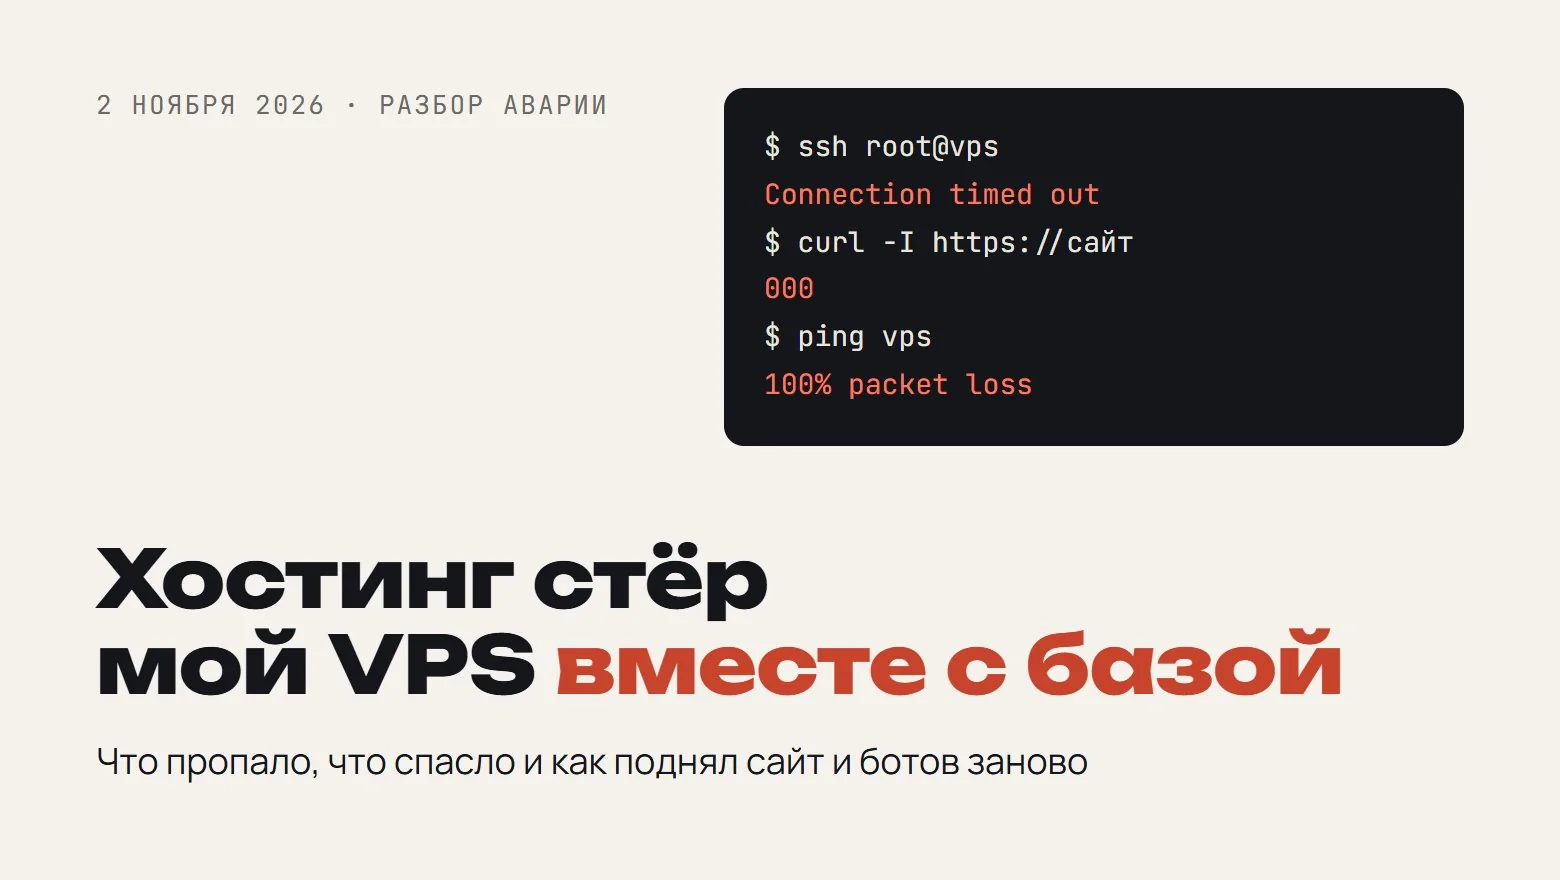
Потеря сервера вместе с базой данных — сценарий, который большинство воспринимает как абстрактную страшилку, пока не столкнётся лично. В описанном случае хостинг взломали, VPS исчез, а вместе с ним — база и рабочие сервисы. Важнее не сама драма, а то, что именно помогло восстановиться и какие решения стоит принять заранее, чтобы не оказаться в похожей ситуации. Ниже — практический разбор без паники: что проверить, как выстроить план переезда и какие ошибки чаще всего совершают при аварийном восстановлении.
Что реально спасает, когда сервер пропал
В истории выручили три вещи: скрипт выкладки, аварийная страница на уровне DNS и возможность быстро перезапустить веб-сервер (в примере — Caddy). Обратите внимание: ни одна из них не появилась в момент аварии. Это заранее подготовленные механизмы. Скрипт выкладки позволяет развернуть приложение на новом сервере повторяемыми шагами, а не вручную по памяти. Аварийная страница на DNS даёт возможность показать пользователям понятное сообщение, пока инфраструктура недоступна. Перезапуск веб-сервера — базовая проверка, что конфигурация жива и не зависит от старого окружения.
Вывод простой: восстановление — это не героический подвиг в ночь аварии, а результат подготовки в спокойное время. Если у вас нет ни скрипта развёртывания, ни резервных копий, ни плана, вы будете импровизировать под давлением, и каждая минута простоя будет стоить дороже.
Бэкапы: критерии, которые стоит проверить до аварии
Резервные копии — самый обсуждаемый и самый игнорируемый пункт. Проблема в том, что «бэкап есть» и «бэкап восстанавливается» — разные утверждения. Проверяйте не наличие файлов, а реальный сценарий восстановления.
- Регулярность и глубина: как часто делается копия и насколько глубоко можно откатиться. Для базы важны и ежедневные, и более частые снимки, если данные меняются постоянно.
- Отдельное хранилище: копия не должна лежать на том же сервере или у того же провайдера, иначе при инциденте вы потеряете всё сразу.
- Проверка восстановления: раз в квартал разверните копию на тестовом окружении и убедитесь, что приложение стартует.
- Доступы: ключи и пароли к хранилищу должны быть доступны вам, а не только внутри утраченного сервера.
Типичная ошибка — хранить бэкапы только в панели хостинга и считать, что этого достаточно. В описанном инциденте VPS исчез целиком, а значит, всё, что было привязано к нему, тоже оказалось под вопросом.
Переезд сервисов: почему не всё открывается на новом сервере
После переезда часто выясняется, что часть интеграций не работает. В примере с нового сервера не открылись Telegram и API модели. Причины обычно прозаичны: изменился IP-адрес, и внешние сервисы блокируют или не узнают новое окружение; настройки сети и фаервола отличаются; переменные окружения и токены остались на старом сервере. Telegram-бот в такой ситуации перешёл на long polling — это обходной путь, который позволяет получать обновления без входящего вебхука, но он не заменяет полноценную настройку.
Что делать по шагам при переезде:
- Составьте список всех внешних зависимостей: боты, платёжные API, модели, вебхуки, DNS-записи.
- Проверьте, какие из них привязаны к IP или домену, и обновите настройки на стороне сервисов.
- Храните конфигурацию в репозитории или менеджере секретов, а не только на сервере.
- После переезда пройдите по каждому сервису и убедитесь, что он отвечает, а не просто «должен работать».
Ошибка — считать, что достаточно поднять приложение. Интеграции ломаются тихо, и вы узнаёте об этом от пользователей или по упавшим метрикам.
Простой и его цена: как считать и что оптимизировать
В истории упоминаются три с половиной дня простоя при включённой рекламе. Это важный момент: простой — не абстракция, а измеримая величина. Считайте его в деньгах и в упущенных действиях пользователей. Если реклама продолжает крутиться, а посадочная страница недоступна, бюджет тратится впустую. Поэтому аварийная страница и возможность быстро отключить или перенаправить трафик — не роскошь, а базовая гигиена.
Что помогает сократить простой:
- Заранее подготовленный сценарий развёртывания на чистом сервере.
- Понятный чек-лист первого часа: DNS, веб-сервер, база, интеграции.
- Мониторинг, который сообщает о недоступности раньше пользователей.
- Регулярные учения: раз в несколько месяцев поднимите копию с нуля и замерьте время.
Не стоит гнаться за идеальной отказоустойчивостью с первого дня. Начните с малого: отдельное хранилище для бэкапов, скрипт развёртывания и аварийная страница. Эти три шага закрывают большинство сценариев, с которыми сталкиваются небольшие проекты.
Типичные ошибки при восстановлении
Первая ошибка — восстанавливать всё сразу и вручную, без плана. Вторая — доверять «здоровью» сервиса без проверки: открылся сайт, значит, всё хорошо, а база при этом пустая или интеграции молчат. Третья — хранить секреты и конфиги только на утраченном сервере. Четвёртая — не фиксировать, что именно сломалось и почему, из-за чего следующая авария снова превращается в сюрприз.
Практичный подход: после восстановления проведите короткий разбор. Что сработало, что заняло больше времени, чем ожидалось, какие данные пришлось восстанавливать вручную. Запишите выводы и внесите изменения в инфраструктуру. Именно так авария превращается в улучшение, а не в повторяющийся кошмар.
И главное: не полагайтесь на заверения хостинга, что «всё под контролем». Ответственность за данные и доступность сервиса лежит на вас. Бэкапы, скрипты и план действий — это не паранойя, а минимальный набор для спокойного сна.