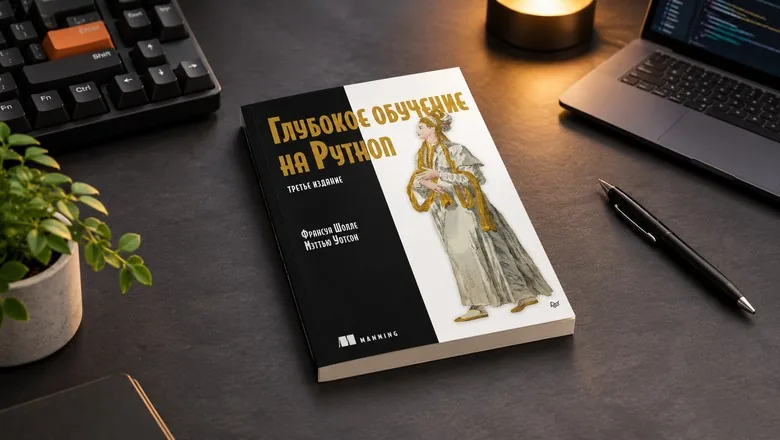
Третье издание «Глубокого обучения на Python» — заметное событие для тех, кто работает с машинным обучением. Авторы — Франсуа Шолле, создатель Keras, и Мэттью Уотсон из команды Gemini — переработали материал с учётом двух тектонических сдвигов: сначала библиотеки вроде TensorFlow, Keras и PyTorch вывели нейросети из лабораторий в продакшен, а затем генеративный ИИ и LLM изменили ожидания бизнеса. В этом обзоре — без пересказа аннотации: кому книга будет полезна, что в ней изменилось и как читать её с практической отдачей.
Кому и зачем читать
Книга не обещает «профессию за 30 дней» и не пытается быть справочником по всем фреймворкам. Её сильная сторона — связка теории и кода на Python. Если вы уже знакомы с основами машинного обучения (знаете, что такое функция потерь, градиентный спуск, переобучение), но хотите понять, как устроены современные модели, — это подходящий вариант. Новичкам без опыта программирования будет тяжело: предполагается уверенное владение Python и базовые знания линейной алгебры.
Практикующим разработчикам книга даёт структурированный путь от классических нейросетей к трансформерам и генеративным моделям. Менеджерам и продактам, которые хотят понимать, «что под капотом», будет полезно выборочное чтение глав про архитектуры и ограничения моделей — без углубления в код.
Что изменилось в третьем издании
Главное отличие от предыдущих версий — акцент на современных архитектурах и инструментах. Авторы добавили материал про трансформеры, генеративный ИИ и практические сценарии дообучения. В книге разбираются проекты, которые можно повторить: сборка собственной мини-модели GPT, диффузионная модель для генерации изображений, дообучение языковой модели методом LoRA. Это не «игрушечные» примеры ради примеров — они показывают, как устроены реальные пайплайны, пусть и в уменьшенном масштабе.
При этом книга не превращается в сборник рецептов под конкретную версию библиотеки. Шолле и Уотсон объясняют принципы, которые переживут смену фреймворков. Это важно: гонка за актуальными API быстро устаревает, а понимание механик остаётся.
Как читать с пользой: конкретные шаги
Чтобы книга не осталась стопкой прочитанных страниц, стоит выстроить работу с ней как с проектом. Вот последовательность, которая снижает риск «прочитал и забыл»:
- Начните с оглавления и предисловия. Отметьте главы, которые напрямую касаются вашей задачи: если вы работаете с текстами — блок про трансформеры и LLM, если с изображениями — про диффузионные модели.
- Заведите репозиторий. Код из книги запускайте локально или в облачной среде, фиксируйте изменения и экспериментируйте с гиперпараметрами. Простое копирование примеров даёт мало.
- Делайте паузы на теорию. Если пример с LoRA непонятен, вернитесь к главе о fine-tuning и убедитесь, что понимаете, какие веса замораживаются и почему.
- Сравнивайте с документацией. Библиотеки обновляются быстрее книг. Сверяйте API с официальными доками Keras, TensorFlow или PyTorch — так вы заодно научитесь работать с первоисточниками.
- Фиксируйте результаты. Ведите короткий журнал: что запустили, какие метрики получили, что сломалось. Это пригодится в собственных проектах и на собеседованиях.
Типичные ошибки при изучении
Первая и самая частая — пытаться прочитать книгу целиком «от корки до корки» без практики. Материал плотный, и без запуска кода понимание остаётся поверхностным. Вторая ошибка — ожидать, что после книги вы сразу сможете обучать большие модели. Реальные LLM требуют ресурсов, данных и инженерной инфраструктуры; книга даёт понимание принципов и навыки работы с уменьшенными версиями.
Третья ошибка — игнорировать главы про основы, если вы уже «что-то слышали» о нейросетях. Авторы последовательно выстраивают понятия, и пропуск базы аукнется на трансформерах. Четвёртая — воспринимать книгу как истину в последней инстанции по инструментам: версии библиотек и рекомендуемые практики меняются, поэтому критическое мышление и проверка по документации обязательны.
Наконец, не стоит ждать от книги готовых бизнес-решений. Она про то, как устроены модели и как их строить, а не про то, какую задачу автоматизировать в вашей компании. Последнее — отдельная работа с данными и постановкой задачи.
Кому книга не подойдёт
Если вы ищете вводный курс по Python или хотите освоить анализ данных без программирования — это не тот источник. Также книга не заменит специализированные материалы по MLOps, развёртыванию моделей в продакшене и работе с инфраструктурой. Она закрывает другой слой: понимание архитектур и практическая сборка моделей на Python. Если ваша цель — быстро сделать первый проект «под ключ» без глубокого погружения, возможно, стоит начать с более прикладных руководств, а к этой книге вернуться позже.
В целом третье издание — это обновлённая база для тех, кто хочет разбираться в глубоком обучении не на уровне терминов, а на уровне кода и архитектур. Читайте выборочно, запускайте примеры и сверяйтесь с документацией — тогда книга станет рабочим инструментом, а не просто ещё одним томом на полке.