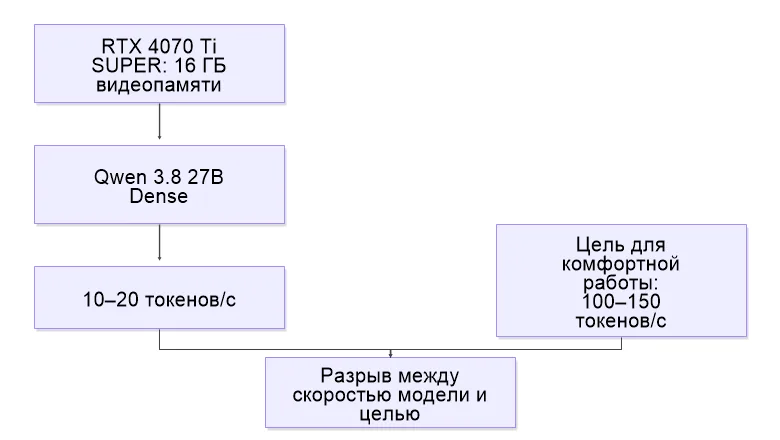
Локальные LLM всё чаще используют не только для экспериментов, но и как рабочий инструмент: автодополнение кода, генерация тестов, рефакторинг, разбор ошибок. Но когда дело доходит до видеокарт с 16 ГБ памяти, пользователи упираются в компромисс: либо модель умная, но медленная, либо быстрая, но слабая. В статье на Habr автор описывает опыт запуска кодинг-агента на RTX 4070 Ti SUPER и целевой ориентир в 100–150 токенов в секунду. Разберём, из чего складывается эта скорость и что можно сделать на своём железе.
Почему 16 ГБ — это ограничение, но не приговор
16 ГБ видеопамяти — распространённый объём среди настольных GPU. По данным опросов, такие карты занимают заметную долю рынка. Для LLM это означает: модель должна помещаться в память вместе с контекстом и служебными буферами. Если модель не влезает, часть слоёв уходит в оперативную память или на диск, и скорость падает в разы. Поэтому первый шаг — честно оценить, сколько памяти займут веса модели в выбранном формате и какой контекст вы планируете держать.
Практический ориентир: для агентных сценариев с длинным контекстом (несколько тысяч токенов) запас памяти нужен больше, чем для чата. Если вы запускаете модель в формате с потерями (квантизация), проверяйте не только размер файла, но и качество на ваших задачах: код чувствителен к ошибкам в синтаксисе и логике.
Скорость генерации: от чего зависит и что настраивать
Токены в секунду зависят от архитектуры модели, формата весов, размера батча, длины контекста и эффективности инференс-движка. Плотные (dense) модели с большим числом параметров на 16 ГБ часто дают двузначные значения токенов в секунду, чего недостаточно для интерактивного агента. Чтобы приблизиться к комфортным 100+ токенам в секунду, обычно приходится выбирать между размером модели и скоростью.
- Размер и архитектура. Компактные модели и модели с разреженной активацией (MoE) могут быть быстрее при сопоставимом качестве на узких задачах.
- Квантизация. 4-битные форматы экономят память и ускоряют генерацию, но требуют проверки на ваших промптах. Для кода тестируйте на реальных файлах, а не на абстрактных примерах.
- Длина контекста. Чем больше контекст, тем больше вычислений на каждый новый токен. Для агента полезно ограничивать историю и передавать только нужные фрагменты кода.
- Движок инференса. Разные движки по-разному работают с памятью и батчингом. Сравнивайте на одной модели и одинаковых промптах, а не по чужим бенчмаркам.
Отдельно стоит учитывать накладные расходы агента: вызовы инструментов, парсинг ответов, повторные запросы. Даже при высокой скорости генерации агент может тормозить из-за логики оркестрации.
Как собрать кодинг-агента: пошаговый план
Начните с постановки задачи. Кодинг-агент — это не только модель, но и сценарий: какие действия он выполняет, какие инструменты вызывает, как проверяется результат. Без этого любая скорость останется бесполезной.
- Шаг 1. Определите минимальный сценарий. Например: принять задачу, найти файлы, предложить патч, запустить тесты. Ограничьте свободу агента, чтобы снизить число токенов на цикл.
- Шаг 2. Выберите модель под железо. Сначала измерьте скорость и качество на 2–3 кандидатах в одном формате. Критерии: проходит ли модель ваши тесты, сколько токенов в секунду выдаёт на контексте нужной длины, сколько памяти остаётся в запасе.
- Шаг 3. Настройте квантизацию и движок. Сравните форматы весов и параметры движка на одинаковых промптах. Фиксируйте не только скорость, но и долю корректных ответов.
- Шаг 4. Ограничьте контекст. Передавайте агенту только релевантные фрагменты кода и краткую историю. Это часто даёт больше прироста, чем смена модели.
- Шаг 5. Добавьте проверки. Линтеры, тесты и статический анализ должны отсекать ошибки. Не полагайтесь на модель в вопросах корректности.
Пример: если агент генерирует патч и запускает тесты, то время цикла складывается из генерации, выполнения тестов и повторной генерации при ошибке. Ускорение генерации в два раза не ускорит цикл вдвое, если тесты занимают столько же времени.
Типичные ошибки и критерии выбора
Одна из частых ошибок — гнаться за самой крупной моделью, которая формально помещается в память. На практике она может выдавать 10–20 токенов в секунду, и работать с ней как с агентом неудобно. Другая ошибка — оценивать скорость по одному короткому запросу, забывая про длинный контекст и повторные вызовы.
- Ошибка: сравнивать модели по чужим бенчмаркам без учёта вашего движка и формата весов. Как избежать: замеряйте на своём железе и своих задачах.
- Ошибка: игнорировать качество квантизации. Как избежать: прогоняйте набор реальных задач и считайте долю исправлений.
- Ошибка: строить агента без ограничений на действия. Как избежать: задайте чёткие шаги, лимиты на итерации и проверки результата.
Критерии выбора модели для локального кодинг-агента: помещается в память с запасом, выдаёт приемлемую скорость на вашем контексте, проходит ваши тесты, поддерживается выбранным движком. Если модель не проходит хотя бы один критерий, лучше взять более компактный вариант и усилить проверки, чем мириться с медленной работой.
В итоге локальный агент на 16 ГБ — это инженерная задача про баланс. Целевые 100–150 токенов в секунду достижимы не на любой модели, но при разумном выборе архитектуры, формата весов и ограничении контекста можно получить инструмент, с которым комфортно работать. Главное — измерять, а не верить обещаниям.