Маршрутизация запросов между языковыми моделями — это не просто выбор «самой умной» модели. Речь о том, чтобы для каждой задачи подобрать исполнителя, который даст приемлемое качество с минимальными затратами. В статье разберём внутреннее устройство такого маршрутизатора: как запрос превращается в вектор, как сравниваются кандидаты, зачем нужен судья и как система учится на отзывах. Материал будет полезен тем, кто проектирует собственные пайплайны с несколькими LLM или оценивает готовые решения.
Вектор задачи: как запрос превращается в признаки
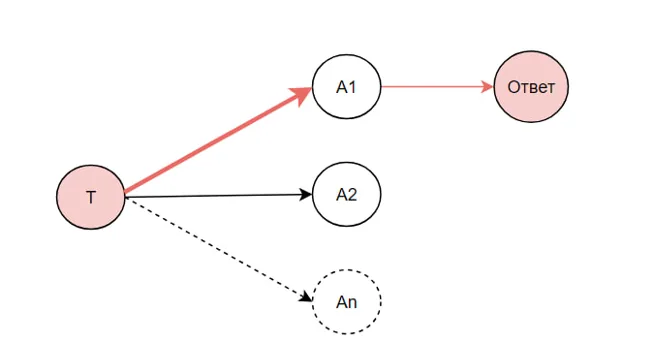
Первый шаг любого маршрутизатора — понять, с чем он имеет дело. Запрос пользователя (или фрагмент диалога) кодируется в векторное представление с помощью эмбеддинговой модели. Это может быть отдельная небольшая модель или один из кандидатов, но чаще используют лёгкий энкодер, чтобы не тратить ресурсы на предварительный этап. Полученный вектор сравнивается с заранее размеченными кластерами задач: например, «код», «аналитика», «творчество», «фактология».
Важно, что вектор задачи — это не просто тема. В него стоит включать длину запроса, язык, наличие кода или таблиц, требования к формату ответа. На практике удобно комбинировать эмбеддинг текста с ручными признаками. Например, если в запросе есть блок кода, это сильный сигнал в пользу модели, специализирующейся на программировании. Если запрос короткий и фактический — возможно, хватит дешёвой модели.
Типичная ошибка — использовать только эмбеддинг без нормализации и без учёта структуры. В результате маршрутизатор путает задачи с похожей лексикой, но разными требованиями. Решение: добавить эвристики и периодически проверять качество кластеризации на размеченной выборке.
Оценка кандидатов: критерии и скоринг
Когда задача представлена вектором, маршрутизатор должен выбрать исполнителя. Кандидаты — это доступные LLM с их характеристиками: стоимость за токен, средняя задержка, поддерживаемые модальности, максимальная длина контекста, известные сильные и слабые стороны. На этом этапе строится функция полезности, которая combines несколько факторов.
- Качество на задаче. Можно хранить исторические оценки для похожих запросов или использовать предобученный классификатор, предсказывающий вероятность успеха.
- Стоимость. Учитывайте не только цену за токен, но и средний расход токенов на ответ для данной задачи.
- Задержка. Для интерактивных сценариев критична; для фоновых — менее важна.
- Ограничения. Длина контекста, поддержка изображений, доступность API.
Простейший вариант — взвешенная сумма с весами, настроенными вручную. Более продвинутый — обучение ранжирующей модели на логах: какие модели давали хорошие ответы для похожих векторов. Не стоит пытаться оптимизировать всё сразу: начните с двух-трёх ключевых критериев, добавьте остальные по мере накопления данных.
Частая ошибка — статический порог «если задача сложная, берём дорогую модель». Сложность плохо определяется одним признаком. Лучше использовать калиброванный скор и периодически пересматривать пороги на валидации.
Судья: как оценивать качество без разметки
Чтобы маршрутизатор учился, нужна обратная связь. Один из способов — использовать судью (judge) — другую LLM, которая оценивает ответ по заданным критериям: релевантность, полнота, соответствие формату, отсутствие галлюцинаций. Судья может быть как отдельной моделью, так и одной из кандидатов, но важно, чтобы его оценки были стабильными.
На практике судью просят выставить оценку по шкале и кратко обосновать. Обоснование помогает отлавливать ошибки: если судья хвалит ответ, но в комментарии противоречит себе, это сигнал о ненадёжности. Для повышения надёжности используют несколько судей и агрегируют результаты, либо калибруют одного судью на небольшом наборе с эталонными оценками.
Типичная ошибка — слепо доверять судье. Он может быть смещён в сторону более многословных ответов или моделей того же семейства. Решение: периодически сверять оценки судьи с человеческой разметкой и добавлять штрафы за нежелательные паттерны (например, за воду).
Обучение на отзывах: от логов к улучшению маршрутизации
Собранные оценки (от судьи или пользователей) становятся обучающими данными. Задача маршрутизатора — предсказывать, какой исполнитель даст лучший результат для данного вектора задачи. Это можно сформулировать как задачу классификации (выбор из N моделей) или регрессии (предсказание скора качества для каждой модели).
Процесс выглядит так:
- Собирайте логи: вектор задачи, выбранная модель, оценка, стоимость, задержка.
- Раз в неделю или две переобучайте модель маршрутизации на накопленных данных, используя временное разделение (обучение на старых, валидация на новых).
- Внедряйте A/B-тестирование: часть трафика направляйте на новую версию маршрутизатора, сравнивайте среднюю оценку и затраты.
- Добавляйте исследовательскую составляющую (epsilon-greedy), чтобы не застрять на популярных моделях и собирать данные о новых.
Важно не переобучиться на предпочтениях судьи. Если судья систематически завышает оценки определённой модели, маршрутизатор будет выбирать её слишком часто. Регулярно проводите аудит и добавляйте человеческие проверки.
Ещё одна ошибка — игнорировать дрейф. Модели обновляются, цены меняются, задачи эволюционируют. Маршрутизатор, обученный полгода назад, может стать неоптимальным. Настройте мониторинг: если средняя стоимость растёт без роста качества, пора переобучать.
В итоге маршрутизатор — это не волшебная кнопка, а инженерная система, которая требует сбора данных, калибровки и регулярного обслуживания. Начните с простой эвристики, добавьте судью для обратной связи, затем обучите лёгкую модель на логах. Такой подход даёт предсказуемый результат без лишних затрат.