Когда в проекте появляется вторая или третья языковая модель, разработчик часто сталкивается с неожиданной сложностью: каждая модель требует отдельного API-ключа, своей авторизации, иногда несовместимого формата запросов и ответов. В результате код обрастает условными конструкциями, а поддержка превращается в рутину. В этой статье разберём, как систематизировать работу с разными LLM, какие подходы существуют и на что обратить внимание, чтобы не увязнуть в интеграциях.
Почему несколько LLM — это инфраструктурная задача
На старте кажется, что подключить ещё одну модель просто: добавить SDK, прописать ключ, вызвать метод. Но чем больше провайдеров, тем больше различий: где-то авторизация через заголовок, где-то через параметр запроса; у одних API совместим с OpenAI, у других — собственный протокол; статистика расходов разбросана по личным кабинетам. Всё это приводит к тому, что разработчик тратит время не на логику приложения, а на обёртки и обработку ошибок. Кроме того, при смене модели приходится переписывать код, что замедляет эксперименты и повышает риск багов.
Типичный пример: вы используете GPT для генерации текста, Claude для анализа документов, а DeepSeek — для код-ревью. Каждый вызов оборачивается в свою функцию с уникальными параметрами. Если завтра нужно заменить Claude на Gemini, придётся менять не только ключ, но и структуру запроса. Это отнимает время и создаёт зависимость от конкретного вендора.
Что такое единый API-шлюз для LLM
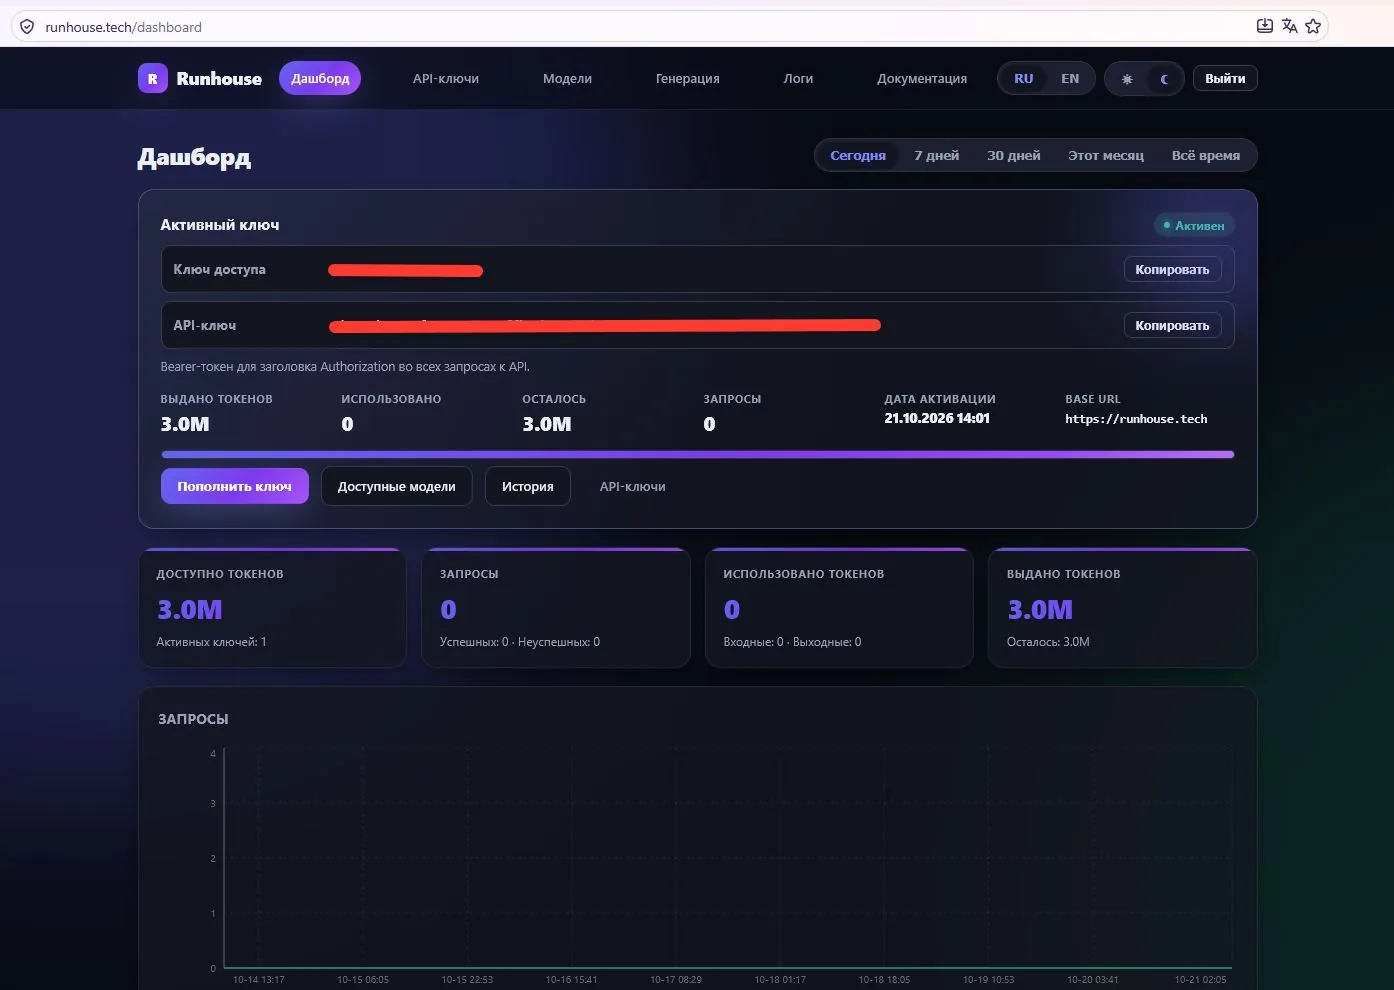
Решение — абстрагироваться от провайдеров с помощью промежуточного слоя, который предоставляет единый интерфейс. Такой шлюз принимает запросы в одном формате, а внутри маршрутизирует их к нужной модели, конвертирует данные и возвращает ответ в стандартном виде. Это может быть собственный сервис или готовое решение, например Runhouse, который объединяет доступ к разным AI API через один интерфейс.
Преимущества подхода:
- Единая авторизация и управление ключами — не нужно хранить десяток токенов в разных местах.
- Стандартизированный формат запросов и ответов — упрощает код и тестирование.
- Централизованная статистика и биллинг — видно, сколько потрачено на каждую модель.
- Быстрое переключение между моделями без изменения приложения.
- Возможность добавить кэширование, ретраи и балансировку на уровне шлюза.
Однако важно понимать, что шлюз — не волшебная таблетка. Он добавляет сетевой хоп и может стать единой точкой отказа. Поэтому при выборе решения стоит оценить надёжность, задержки и поддержку нужных вам моделей.
Критерии выбора подхода
Прежде чем внедрять шлюз, определитесь, что для вас важнее. Вот несколько критериев:
- Список поддерживаемых моделей. Убедитесь, что шлюз работает с теми LLM, которые вы используете сейчас или планируете в ближайшем будущем.
- Совместимость с OpenAI API. Многие инструменты используют этот формат как стандарт. Если шлюз его поддерживает, миграция будет проще.
- Управление ключами и безопасность. Хорошо, если шлюз позволяет хранить ключи в защищённом виде и разграничивать доступ.
- Мониторинг и логи. Возможность видеть запросы, ошибки и расходы по каждому провайдеру.
- Задержки и география. Если приложение чувствительно к скорости, выбирайте шлюз с серверами в нужном регионе.
- Стоимость. Некоторые шлюзы берут комиссию или фиксированную плату. Сравните с затратами на самостоятельную поддержку.
Если у вас всего одна-две модели и они не меняются, возможно, шлюз не нужен. Но если вы экспериментируете или строите продукт с разными сценариями, единый интерфейс сэкономит много времени.
Типичные ошибки при интеграции нескольких LLM
Даже с шлюзом легко наступить на грабли. Вот что встречается чаще всего:
- Жёсткая привязка к формату ответа. Разные модели возвращают текст в разных форматах (например, JSON может быть обёрнут в markdown). Шлюз должен нормализовать ответы, но проверяйте это на тестах.
- Игнорирование лимитов и ошибок. У каждого провайдера свои rate limits и коды ошибок. Шлюз может сгладить различия, но нужно настроить ретраи и fallback-стратегии.
- Отсутствие мониторинга. Без централизованных логов сложно понять, какая модель даёт сбои или слишком дорога.
- Хранение ключей в коде. Даже при использовании шлюза ключи должны быть в переменных окружения или секретном хранилище.
- Пренебрежение тестированием. При смене модели через шлюз легко получить неожиданное поведение. Пишите интеграционные тесты для критичных сценариев.
Пример из практики: разработчик подключил шлюз, но не учёл, что одна из моделей возвращает ответ в потоковом режиме иначе. В итоге приложение падало при стриминге. Решение — явно указывать параметры стриминга и тестировать каждый сценарий.
Практические шаги по внедрению
Если вы решили упростить работу с LLM, начните с малого:
- Выпишите все модели, которые используете или планируете, и их особенности (формат API, лимиты, стоимость).
- Определите, нужен ли вам готовый шлюз или достаточно собственной обёртки. Для двух-трёх моделей можно написать простой адаптер.
- Выберите инструмент (например, Runhouse или аналог) и проверьте его на тестовом запросе к каждой модели.
- Настройте централизованное логирование и мониторинг расходов.
- Постепенно переводите вызовы на единый интерфейс, начиная с некритичных функций.
- Обязательно протестируйте обработку ошибок и таймаутов.
Не забывайте про безопасность: не передавайте ключи в открытом виде и ограничьте доступ к шлюзу.
В итоге единый API-шлюз — это не просто удобство, а способ снизить связанность кода и упростить эксперименты. Но он требует внимательного выбора и настройки. Если подойти к задаче системно, вы сможете легко менять модели, не переписывая приложение, и сосредоточиться на продукте, а не на интеграциях.