Использование больших языковых моделей (LLM) для оценки задач в story points набирает популярность: это быстро и не требует созывать команду. Однако исследование на исторических задачах Jira показало, что достаточно одной фразы в промпте, например «тимлид считает, что эта задача стоит 5», чтобы оценка двух разных LLM сместилась примерно на 20%. Этот эффект известен как якорение: модель цепляется за число, даже если оно необоснованно. В статье разберём, как это работает, почему близкая к командной оценка не гарантирует точность и как использовать LLM для планирования, не попадая в ловушку.
Что такое эффект якоря в оценке задач
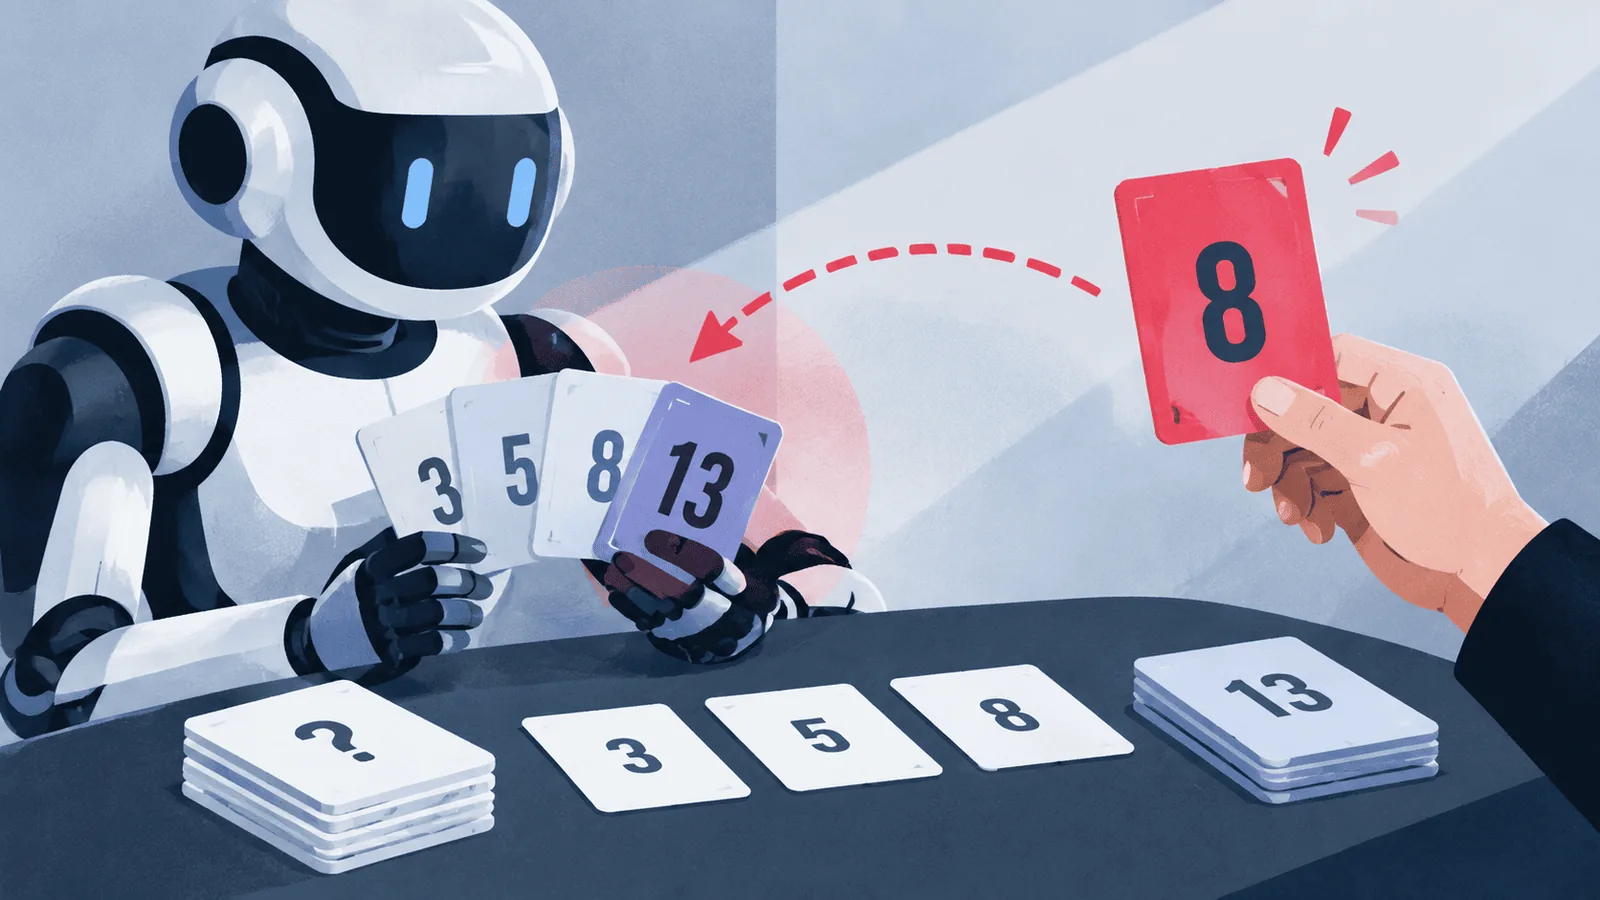
Эффект якоря — когнитивное искажение, при котором люди (и модели) слишком сильно полагаются на первое полученное число. В контексте покер-планирования это проявляется, когда тимлид или другой участник называет свою оценку до обсуждения. Нейросети, обученные на человеческих текстах, также подвержены этому эффекту: если в промпте указать ожидаемую оценку, модель с большей вероятностью выдаст число, близкое к якорю. В эксперименте на реальных задачах Jira добавление фразы «тимлид думает, что это 8» приводило к тому, что оценка LLM снижалась или повышалась в среднем на 20% по сравнению с нейтральным промптом.
Важно понимать: якорь действует не только на людей, но и на алгоритмы. Это значит, что если вы используете LLM для предварительной оценки, любая подсказка с числом может исказить результат. Причём чем менее конкретна задача, тем сильнее влияние якоря.
Как проводился эксперимент и что он показал
Исследователи взяли исторические задачи из Jira с уже известными оценками story points. Для каждой задачи сформировали два промпта: нейтральный (без указания ожидаемой оценки) и с якорем — фразой вроде «тимлид предполагает, что задача стоит X». Затем прогнали через две разные LLM и сравнили результаты с исходными оценками и между собой.
Результаты:
- При наличии якоря оценки обеих моделей смещались в сторону указанного числа в среднем на 20%.
- Даже когда якорь был явно завышен или занижен, модели корректировали оценку, но не игнорировали его полностью.
- Сумма оценок по задачам, полученная с помощью LLM, часто оказывалась близка к командной, но это не означало, что каждая отдельная оценка точна — ошибки компенсировались.
Этот результат подчёркивает: LLM не даёт объективной оценки, а лишь отражает вероятностное распределение, на которое легко повлиять контекстом.
Почему близкая к командной сумма не гарантирует точность
Если сложить оценки LLM по всем задачам спринта и сравнить с суммой командных оценок, можно получить почти одинаковые числа. Но за этой близостью могут скрываться значительные расхождения по отдельным задачам: одни недооценены, другие переоценены. Например, задача, которую команда оценила в 5, модель с якорем «3» поставит 4, а задачу с командной оценкой 2 — тоже 4. В сумме получится то же самое, но план спринта будет искажён.
Кроме того, LLM не учитывает контекст: зависимости между задачами, опыт команды, технический долг. Поэтому использовать сумму оценок как критерий качества нельзя — нужно смотреть на каждую задачу отдельно.
Как использовать LLM для оценки задач без вреда
Чтобы минимизировать эффект якоря и повысить полезность LLM, следуйте этим шагам:
- Формулируйте промпт нейтрально. Не упоминайте ожидаемую оценку, имя тимлида или другие числа. Пример: «Оцени сложность задачи в story points по шкале Фибоначчи, учитывая только описание».
- Запрашивайте обоснование. Попросите модель объяснить, почему она поставила такую оценку, какие факторы учла. Это поможет выявить логические ошибки.
- Сравнивайте несколько прогонов. Запустите оценку несколько раз с разными формулировками (но без якорей) и посмотрите на разброс. Если оценки сильно скачут, задача сформулирована нечётко.
- Используйте LLM как вспомогательный инструмент, а не замену обсуждению. Полученные оценки можно вынести на покер-планирование как один из голосов, но не как истину.
- Проверяйте на исторических данных. Если у вас есть задачи с известными оценками, прогоните их через модель и сравните с эталоном — так вы поймёте, насколько она адекватна для вашего домена.
Также стоит избегать ситуаций, когда LLM используется для «подтверждения» уже принятого решения — это прямой путь к подтверждающему искажению.
Типичные ошибки при оценке задач с помощью LLM
Вот что чаще всего делают не так:
- Указывают в промпте оценку тимлида или заказчика. Это создаёт якорь и смещает результат.
- Используют сумму оценок как метрику точности. Как показал эксперимент, сумма может совпадать, а отдельные оценки — быть далёкими от истины.
- Игнорируют контекст. LLM не знает о зависимостях, квалификации команды, предыдущем опыте. Без дополнительной информации оценка будет поверхностной.
- Переносят оценку LLM в план без обсуждения. Это лишает команду возможности уточнить детали и договориться.
- Не проверяют модель на своих данных. Разные LLM могут давать разные результаты, и то, что работает для одной команды, не подойдёт для другой.
Пример: команда решила автоматизировать оценку бэклога с помощью LLM. В промпт добавили фразу «по мнению продакт-менеджера, это примерно 5». В итоге все задачи, которые продакт-менеджер считал крупными, получили завышенные оценки, а мелкие — заниженные. Спринт был перегружен, потому что реальная сложность не соответствовала цифрам.
Вывод: LLM — инструмент, а не оракул
Нейросети могут ускорить оценку задач, но требуют осторожного обращения. Эффект якоря — лишь одна из ловушек. Чтобы извлечь пользу, формулируйте промпты нейтрально, запрашивайте обоснования, проверяйте модель на исторических данных и всегда обсуждайте результаты с командой. Помните: близкая к командной сумма не гарантирует точность, а одна фраза в промпте может срезать оценку на пятую часть. Используйте LLM как дополнительный голос, а не как замену экспертизе команды.