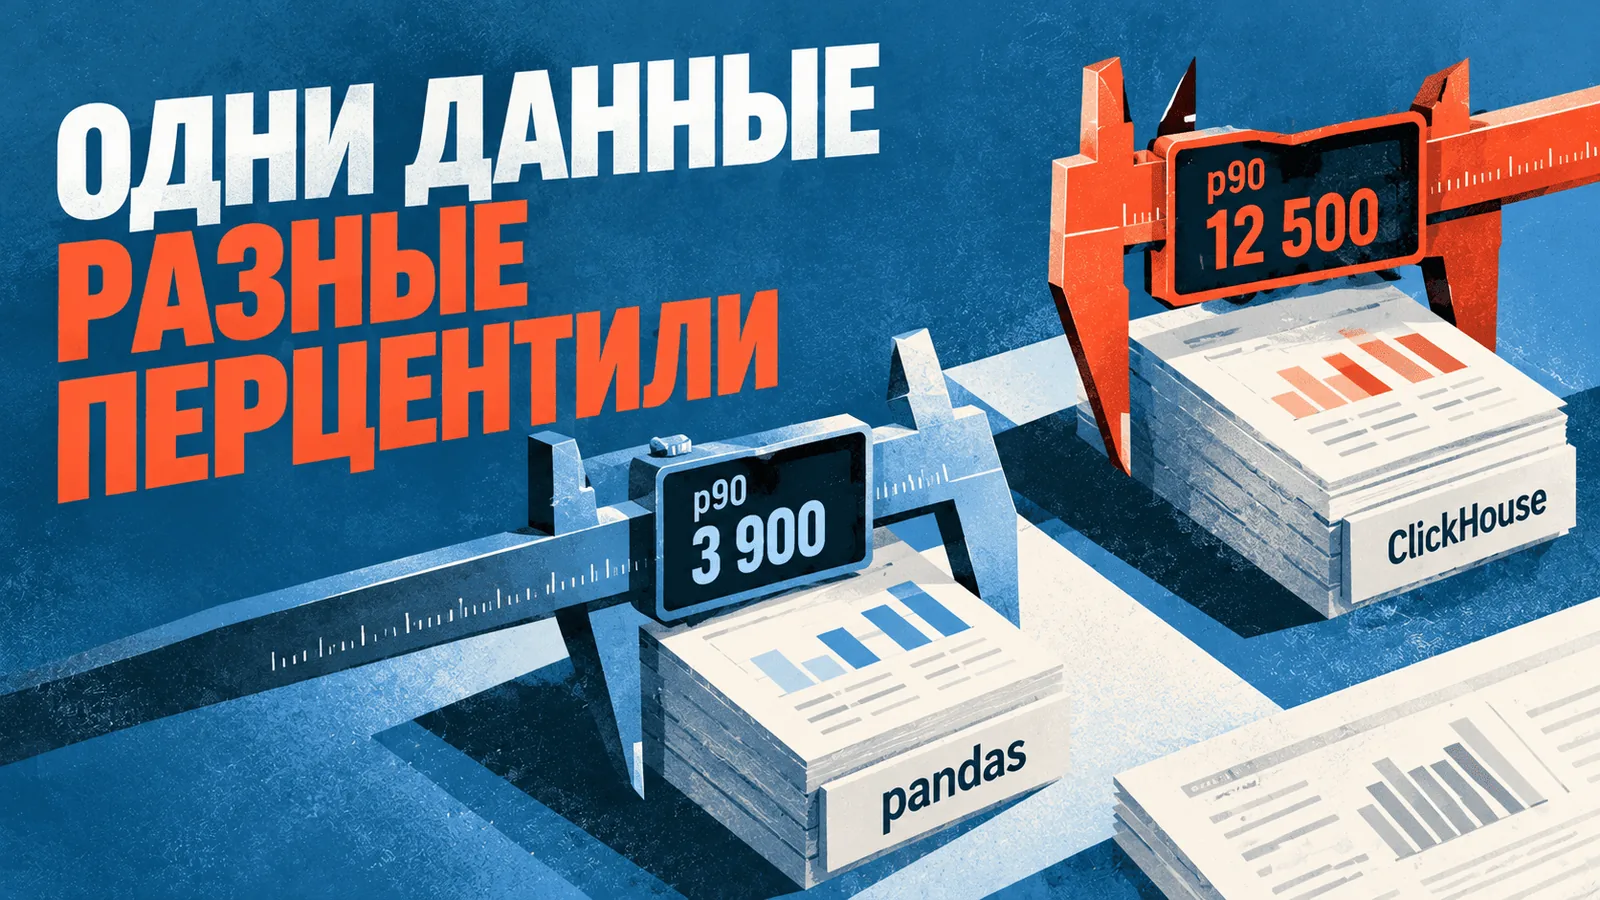
Вы аналитик, и перед вами стоит задача: посчитать 90-й перцентиль времени доставки заказов. В Jupyter Notebook с pandas вы получаете 3900 рублей, а на дашборде в ClickHouse — 12 500. Разница в три раза. И даже повторный запуск запроса иногда даёт другое число. Почему так происходит и как добиться согласованных результатов? Причина кроется в деталях реализации функции перцентиля: разные инструменты используют разные алгоритмы интерполяции и обработки граничных случаев. В этой статье разберём, как именно считают перцентили pandas и ClickHouse, какие подводные камни существуют и что сделать, чтобы метрики совпадали.
Почему перцентили могут различаться
Перцентиль — это значение, ниже которого находится определённый процент наблюдений. Но когда данных немного (например, 10 заказов), разные методы дают разные результаты. Основные причины расхождений:
- Разные методы интерполяции. pandas по умолчанию использует линейную интерполяцию (метод 'linear'), а ClickHouse — метод 'nearest_rank' (ближайшего ранга). Это приводит к разным значениям, особенно на малых выборках.
- Обработка нечётного количества элементов. При нечётном числе наблюдений медиана (p50) может быть центральным элементом или средним двух центральных — в зависимости от реализации.
- Игнорирование или учёт выбросов. Некоторые функции отбрасывают выбросы или обрабатывают NaN по-разному.
- Повторный запуск запроса. Если данные не отсортированы или используются приближённые алгоритмы (например, t-digest в ClickHouse для больших выборок), результат может меняться от запуска к запуску.
Рассмотрим конкретный пример. У нас есть 10 заказов со стоимостями: 100, 200, 300, 400, 500, 600, 700, 800, 900, 1000 рублей. Посчитаем p90.
В pandas с методом 'linear' p90 будет равен 910 (интерполяция между 900 и 1000). В ClickHouse с методом 'nearest_rank' p90 будет равен 900 (ближайший ранг). Если же в ClickHouse использовать метод 'linear', результат совпадёт с pandas. Но если данные содержат выброс, например, 12500, то p90 может сильно измениться в зависимости от метода.
Как считает pandas
В pandas функция quantile() по умолчанию использует линейную интерполяцию (interpolation='linear'). Это означает, что если искомая точка попадает между двумя значениями, она вычисляется как взвешенное среднее. Например, для p90 при 10 элементах позиция равна 0.9*(10-1)=8.1, что соответствует 8-му элементу (с индексом 8) плюс 0.1 от разницы между 9-м и 8-м. В нашем примере: 900 + 0.1*(1000-900) = 910.
pandas также поддерживает другие методы: 'lower', 'higher', 'nearest', 'midpoint'. Их можно указать в параметре interpolation. Однако при работе с большими данными pandas может быть медленным, и аналитики часто переходят на ClickHouse.
Как считает ClickHouse
В ClickHouse есть несколько функций для перцентилей: quantile(), quantileExact(), quantileTiming() и другие. По умолчанию quantile() использует алгоритм t-digest (приближённый) для больших выборок, что может давать неточные результаты и меняться от запуска к запуску. Для точных вычислений используют quantileExact(), который возвращает точное значение, но требует больше памяти.
Важно: quantileExact() по умолчанию использует метод 'nearest_rank'? На самом деле, в документации ClickHouse указано, что quantileExact() возвращает точный перцентиль, но метод интерполяции зависит от версии. В новых версиях появилась функция quantileExactExclusive() и quantileExactInclusive(), которые соответствуют разным методам. Чтобы получить результат, как в pandas с линейной интерполяцией, нужно использовать quantileExactInclusive() или указать соответствующий метод.
Также в ClickHouse есть функция quantileInterpolated(), которая как раз использует линейную интерполяцию. Именно её стоит применять, если вы хотите согласовать результаты с pandas.
Как добиться совпадения результатов
Чтобы перцентили в pandas и ClickHouse совпадали, выполните следующие шаги:
- Выберите единый метод интерполяции. Например, линейный. В pandas это interpolation='linear' (по умолчанию), в ClickHouse — функция quantileInterpolated() или quantileExactInclusive().
- Убедитесь в одинаковой обработке граничных случаев. Проверьте, как оба инструмента обрабатывают NaN и выбросы. В pandas можно удалить NaN перед расчётом, в ClickHouse — использовать фильтр WHERE.
- Избегайте приближённых алгоритмов. В ClickHouse не используйте quantile() без указания точного метода, если важна точность. Для малых выборок лучше quantileExact().
- Сортируйте данные. Некоторые приближённые алгоритмы чувствительны к порядку данных. Явная сортировка перед расчётом поможет стабилизировать результат.
- Проверьте версии инструментов. В разных версиях pandas и ClickHouse реализации могут меняться. Зафиксируйте версии в requirements.txt и в настройках сервера.
- Напишите тесты. Создайте небольшой набор данных с известными перцентилями и проверяйте, что оба инструмента дают одинаковый результат.
Пример: в pandas используйте df['value'].quantile(0.9, interpolation='linear'). В ClickHouse — SELECT quantileInterpolated(0.9)(value) FROM table. Тогда на одинаковых данных результаты совпадут.
Типичные ошибки и примеры
Рассмотрим несколько распространённых ошибок, приводящих к расхождениям:
- Использование quantile() в ClickHouse без указания метода. По умолчанию может применяться приближённый алгоритм, который даёт другое значение. Решение: явно указывать quantileExact() или quantileInterpolated().
- Игнорирование выбросов. Если в данных есть выброс, например, 12500, то p90 в pandas с линейной интерполяцией может сильно отличаться от nearest_rank. Решение: предварительно очистить данные от выбросов или использовать робастные методы.
- Разная обработка нечётного количества элементов. Например, для 5 элементов p50 в pandas с линейной интерполяцией будет средним 3-го элемента, а в ClickHouse с nearest_rank — самим 3-м элементом. Решение: использовать одинаковый метод интерполяции.
- Повторный запуск запроса даёт разные результаты. Это признак приближённого алгоритма (t-digest). Решение: перейти на точные функции.
Пример из практики: аналитик считал p90 времени доставки в pandas и получал 3900 рублей, а в ClickHouse — 12500. Оказалось, что в ClickHouse использовалась функция quantile() с приближённым алгоритмом, а в данных был выброс. После замены на quantileInterpolated() и удаления выброса результаты совпали.
В заключение: чтобы перцентили в pandas и ClickHouse совпадали, нужно явно выбирать метод интерполяции, избегать приближённых алгоритмов и тестировать результаты на контрольных данных. Это позволит получать согласованные метрики и избежать недоверия к дашбордам.