Когда речь заходит о RAG-системах и AI-агентах, по умолчанию обычно предлагают облачные API и управляемые векторные базы. Это быстро, но не всегда приемлемо: для части задач важна автономность, независимость от внешних провайдеров и предсказуемость расходов. Self-hosted подход позволяет держать данные и вычисления внутри своего контура, но требует осознанного выбора каждого компонента. Ниже — практический разбор того, как подойти к сборке такой системы, не превращая её в бесконечный эксперимент.
Из чего состоит self-hosted RAG-стек
Любая RAG-система — это конвейер: сбор данных, их обработка и индексация, поиск релевантных фрагментов и генерация ответа. В self-hosted варианте каждый этап требует своего инструмента, и важно, чтобы они стыковались без лишних прослоек.
- Сбор и нормализация источников. RSS-ленты, API, файлы, внутренние базы. Нужен планировщик задач и очередь, чтобы обработка не блокировала приложение.
- Хранение и индексация. Реляционная база с расширением для векторов (например, PostgreSQL с pgvector) закрывает и метаданные, и эмбеддинги в одном месте.
- Эмбеддинги. Локальная модель, работающая через единый inference-сервер.
- Генерация. Локальная LLM, достаточная по качеству для вашей задачи и по железу — для вашей инфраструктуры.
- Оркестрация агента. Фреймворк, который описывает шаги, вызовы инструментов и состояние диалога.
- Наблюдаемость. Трассировка запросов и ответов, чтобы понимать, где теряется качество.
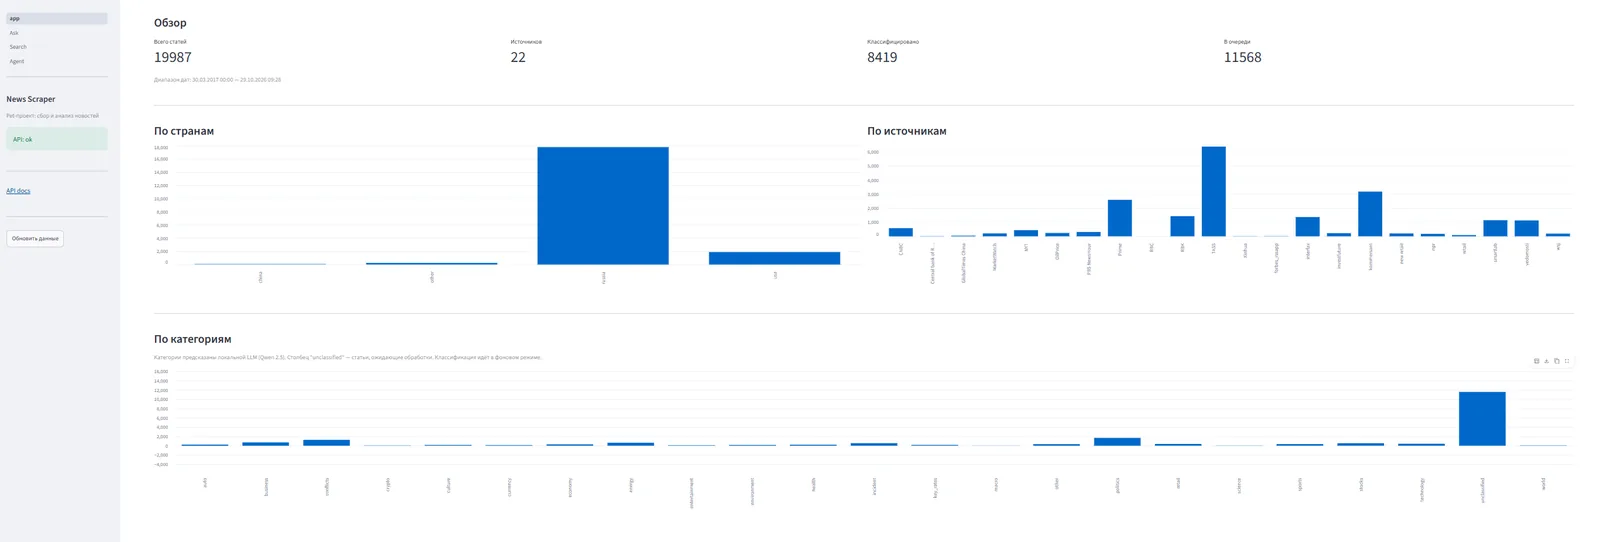
Типовой набор для такого контура: Python как язык glue-кода, FastAPI для API, Celery для фоновых задач, PostgreSQL + pgvector для хранения, Ollama как сервер локальных моделей, LangGraph для агентной логики, Streamlit для быстрого интерфейса и Langfuse для трассировки. Docker объединяет всё в воспроизводимый запуск.
Агент на LangGraph: зачем он нужен в RAG
Классический RAG — это один запрос к векторной базе и один вызов модели. Агент меняет картину: он может сам решать, какой инструмент вызвать, переформулировать запрос, сходить в базу повторно или собрать данные из нескольких источников перед ответом. LangGraph удобен тем, что позволяет описать это как граф состояний, а не как лапшу из условий.
Практический минимум для аналитической системы: узел маршрутизации (понять тип запроса), узел поиска (векторный поиск с фильтрами по метаданным), узел вызова инструментов (например, агрегация по датам или категориям) и узел финальной генерации. Состояние графа хранит исходный вопрос, найденные фрагменты и промежуточные выводы. Это даёт воспроизводимость: вы всегда можете посмотреть, на каком шаге агент свернул не туда.
Важная оговорка: агент не делает систему умнее сам по себе. Если поиск возвращает мусор, а модель слабо следует инструкциям, граф лишь добавит latency и неопределённости. Начинайте с линейного пайплайна и добавляйте ветвления только там, где видите конкретную проблему.
Критерии выбора моделей и векторной базы
Выбор локальных моделей — компромисс между качеством, скоростью и доступным железом. Универсального рецепта нет, но есть проверяемые критерии.
- Размер и квантование. Модель на 7–14 млрд параметров в квантованном виде часто умещается в потребительскую видеокарту. Проверяйте не бенчмарки в вакууме, а качество на ваших реальных вопросах.
- Следование инструкциям. Для агента критично, чтобы модель стабильно возвращала структурированный вывод (JSON, выбор инструмента). Тестируйте это отдельно.
- Контекстное окно. Оно должно вмещать найденные фрагменты плюс инструкции. Слишком большое окно при слабой модели не помогает — она теряет середину.
- Модель эмбеддингов. Многоязычная модель важна, если в данных есть русский текст. Проверяйте качество поиска на своих документах, а не на англоязычных примерах.
По векторной базе критерии проще: если объём данных измеряется десятками тысяч фрагментов, pgvector в PostgreSQL закрывает потребности и упрощает архитектуру — метаданные и векторы живут рядом, фильтры по датам и категориям работают нативно. Отдельная специализированная векторная БД оправдана при больших объёмах и высоких требованиях к latency.
Типичные ошибки и шаги внедрения
Самая частая ошибка — начать с агента и красивой оркестрации, не проверив качество данных и поиска. Вторая — игнорировать чанкинг: слишком крупные фрагменты размывают релевантность, слишком мелкие теряют контекст. Третья — отсутствие наблюдаемости: без трассировки невозможно понять, ошибка в эмбеддингах, в поиске или в генерации.
Разумная последовательность внедрения выглядит так:
- Соберите небольшой корпус реальных документов и вручную оцените, какие фрагменты должны находиться по типовым вопросам.
- Поднимите Ollama и прогоните 2–3 кандидата в LLM и 2 кандидата в эмбеддингах на этом корпусе.
- Соберите линейный RAG-пайплайн с pgvector и замерьте качество ответов до добавления агента.
- Добавьте LangGraph-граф с одним-двумя инструментами и сравните метрики с базовой линией.
- Подключите трассировку и логируйте входы/выходы каждого узла.
- Только после этого автоматизируйте сбор данных через очередь задач и планировщик.
Отдельно про инфраструктуру: контейнеризация обязательна, иначе воспроизвести конфигурацию моделей и версий библиотек будет тяжело. Держите модели и индексы вне контейнера приложения, чтобы обновление кода не требовало переиндексации. И закладывайте запас по памяти: локальные модели и эмбеддинги конкурируют за одни и те же ресурсы.
Self-hosted RAG с агентом — это не один инструмент, а дисциплина: сначала данные и поиск, потом оркестрация, поверх всего — наблюдаемость. Такой подход позволяет получить автономную систему, которая предсказуемо работает на ваших задачах, а не демонстрирует впечатляющие ответы на чужих примерах.