История про переход с тяжёлой legacy-СУБД на современный аналитический движок и self-service модель звучит как реклама, но за ней стоит конкретная инженерная работа. Ниже — разбор подходов, которые позволяют небольшой команде инженеров данных поддерживать десятки аналитиков без отдельного тестового кластера и без бесконечного ручного ревью каждой витрины. Это не инструкция «повторите и получите секунды на запросах», а набор решений, критериев и ограничений, которые стоит оценить под свою задачу.
Что на самом деле означает self-service
Self-service — это не «аналитики делают что хотят». Это модель, в которой аналитик может самостоятельно пройти путь от идеи витрины до её появления в продакшене, не создавая рисков для остальных. Ключевое условие — предсказуемые правила: где лежат исходные данные, как называются объекты, как проверяется качество, кто и когда смотрит изменения.
На практике self-service держится на трёх опорах: управляемый доступ к данным, шаблонизированный процесс сборки (например, через dbt) и автоматические проверки в CI. Если хотя бы одной опоры нет, свобода аналитиков быстро превращается в хаос: дубли витрин, разные трактовки метрик, «временные» таблицы, которые живут годами.
- Доступ: единые роли и понятная схема прав, а не выдача грантов по запросу в чате.
- Процесс: изменения проходят через Git и ревью, а не через правки в веб-интерфейсе.
- Проверки: тесты на уникальность, полноту и допустимые значения запускаются автоматически.
Как обойтись без отдельного тестового стенда
Отсутствие dev-кластера — не экономия ради экономии, а вынужденное ограничение, которое заставляет выстроить дисциплину. Полноценная копия продакшена нужна редко; чаще достаточно изолировать изменения и проверять их на ограниченном наборе данных. Вот несколько рабочих подходов, которые стоит рассмотреть.
- Отдельные схемы или базы под ветку: каждое изменение собирается в изолированном пространстве имён и не пересекается с продакшен-объектами.
- Сэмплирование данных: тесты гоняются на усечённых выборках, а не на полном объёме — это кратно дешевле по ресурсам.
- Эфемерные окружения: среда поднимается на время проверки и удаляется после мержа, вместо постоянного второго кластера.
- Статические проверки в CI: линтеры SQL, проверка зависимостей и контрактов моделей ловят часть ошибок ещё до запуска.
Важно честно оценить границы метода. Проверки на сэмпле не поймают проблемы, связанные с объёмом или редкими значениями. Поэтому критичные витрины всё равно нуждаются в периодической сверке на полных данных — например, по расписанию или перед релизом.
Критерии выбора инструментов и ролей
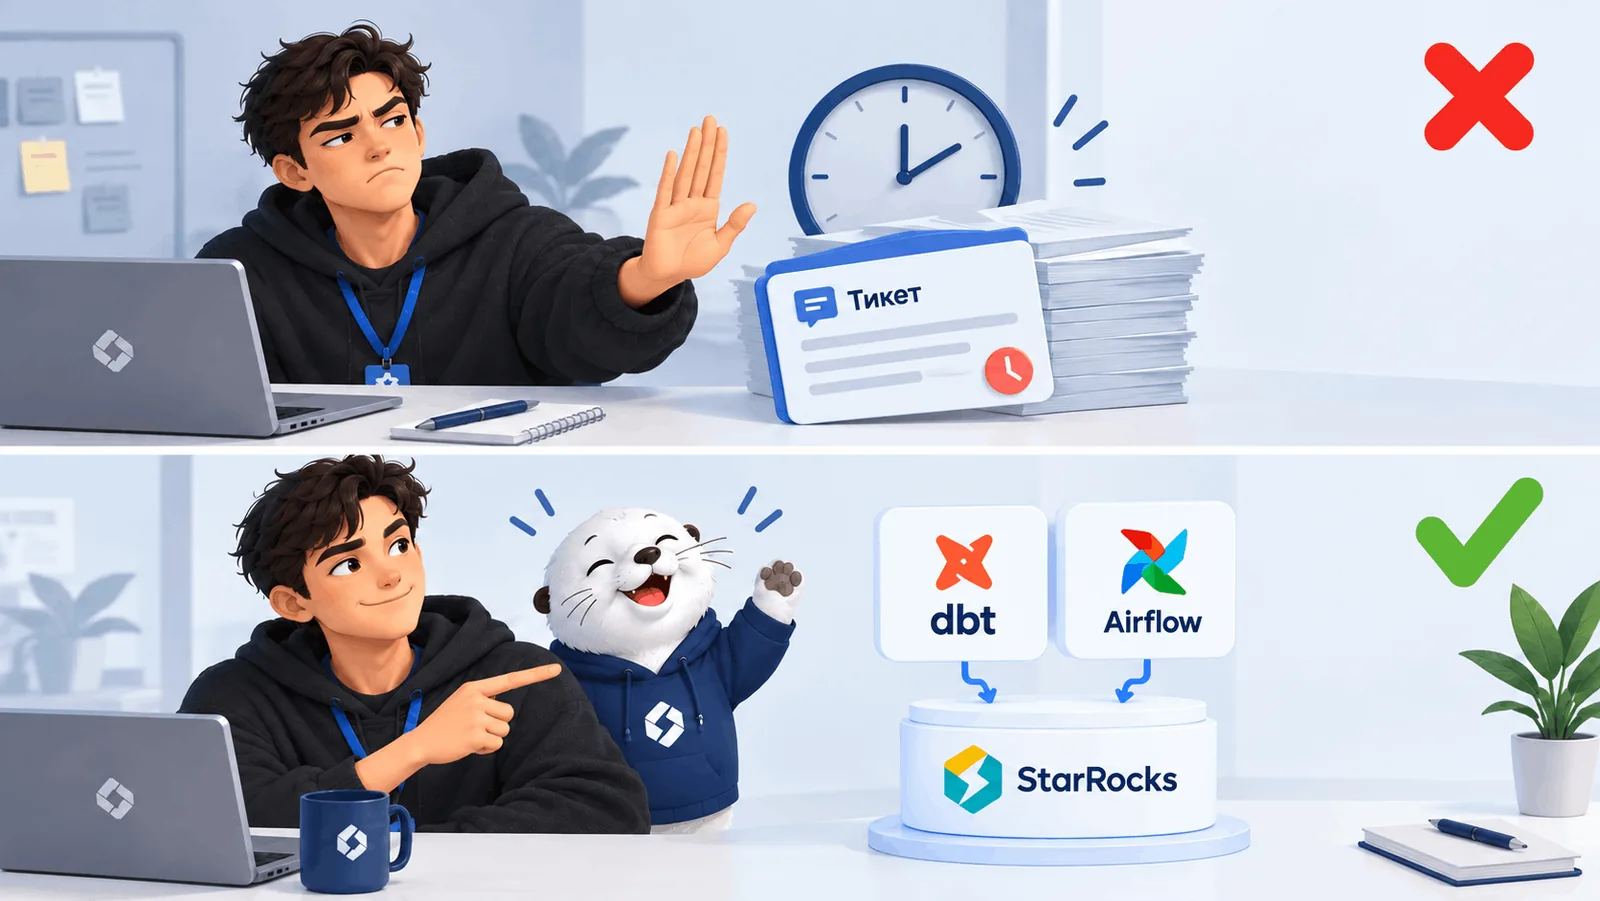
Стек вроде StarRocks + Airflow + dbt привлекателен, но выбор движка и оркестратора должен опираться на конкретные требования, а не на популярность. Сформулируйте критерии до пилота.
- Характер нагрузки: преобладают ли тяжёлые агрегаты, точечные выборки, конкурентный доступ многих пользователей.
- Совместимость: насколько просто мигрировать существующие запросы и процедуры, какие есть драйверы и коннекторы.
- Стоимость эксплуатации: требования к железу, сложность администрирования, наличие экспертизы в команде.
- Экосистема: поддержка со стороны dbt, оркестраторов, BI-инструментов.
Отдельно стоит определить разделение ролей. Три инженера не могут вручную собирать все витрины — их задача строить платформу, шаблоны и guardrails. Аналитики отвечают за логику конкретных витрин и качество метрик. Граница проходит по уровню риска: изменения в общих слоях и инфраструктуре — зона инженеров, прикладные витрины — зона аналитиков при поддержке ревью.
Типичные ошибки и как их избежать
Большинство проблем в self-service возникает не из-за инструментов, а из-за отсутствия договорённостей. Ниже — ошибки, которые встречаются чаще всего, и практичные контрмеры.
- Нет владельца у витрины. Контрмера: у каждой модели есть ответственный, это фиксируется в метаданных.
- Дубли метрик. Контрмера: единый слой определений и ревью перед добавлением новой метрики.
- Тесты «для галочки». Контрмера: тесты привязаны к бизнес-рискам, а падение теста блокирует мерж.
- Ручные правки в продакшене. Контрмера: любые изменения только через Git, доступ на запись в обход процесса закрыт.
- Игнорирование стоимости запросов. Контрмера: лимиты, мониторинг тяжёлых запросов и понятные правила для аналитиков.
Полезно завести короткий чек-лист для новой витрины: источник данных, владелец, ключи, тесты, частота обновления, ожидаемое время ответа. Если чек-лист не заполняется, витрина не готова к продакшену — это проще, чем потом разбираться с противоречивыми цифрами в отчётах.
Что делать, если вы только начинаете
Не стоит начинать с большого переезда. Сначала выберите один домен и пройдите на нём весь путь: от источника до витрины, с тестами и ревью. Это покажет реальные узкие места — будь то права доступа, производительность или привычки команды.
- Зафиксируйте соглашения об именовании и структуре слоёв.
- Настройте CI с базовыми проверками до того, как откроете доступ аналитикам.
- Определите, какие данные можно тестировать на сэмпле, а какие требуют полной сверки.
- Договоритесь о процессе ревью и SLA на его скорость.
- Введите мониторинг качества и стоимости запросов с первого дня.
И главное — не обещайте команде, что «всё будет быстро и само». Self-service работает там, где есть явные правила и готовность их поддерживать. Инструменты вроде StarRocks, dbt и Airflow снижают трение, но не заменяют договорённости. Начните с малого домена, измерьте результат и только потом расширяйте охват.