Когда речь заходит о памяти ИИ-агента, главный вопрос — как хранить и извлекать знания, чтобы модель отвечала точно и не галлюцинировала. Многие выбирают между реляционными базами (SQL) и графами знаний (SPARQL), опираясь на статьи и посты, а не на собственные измерения. В этой статье разберём, что говорят исследования, как провести собственный эксперимент и на что обратить внимание при выборе.
Что говорят исследования
В исследовании Sequeda и соавторов GPT-4 отвечал на вопросы по корпоративной SQL-базе верно в 16% случаев, а по графу знаний поверх той же базы — в 54%. Важное условие: у графа была онтология с описанием, а у SQL-схемы — только DDL с типами и названиями таблиц и колонок. Это подсказывает, что дело не только в языке запросов, но и в наличии семантического слоя.
Практический эксперимент: SQL против SPARQL
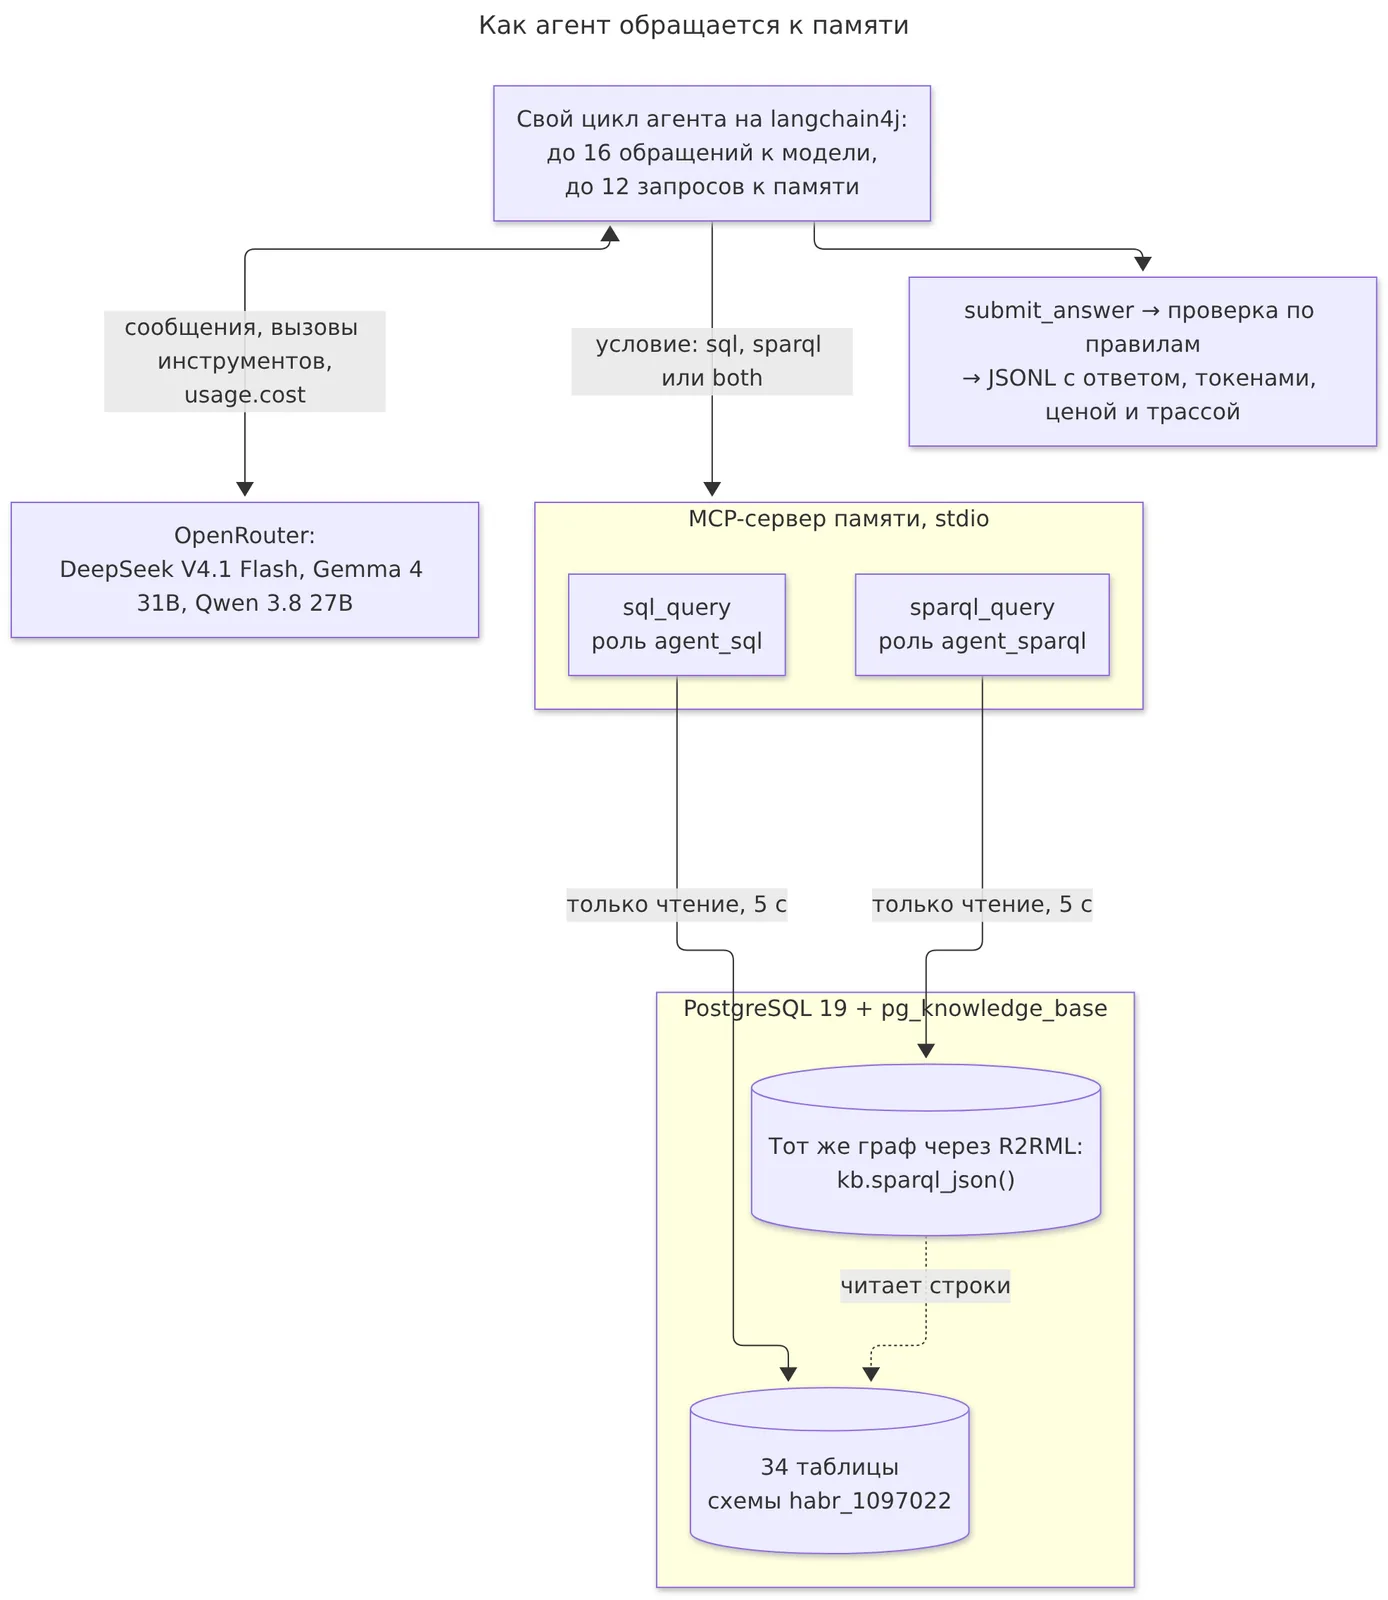
Автор оригинального материала извлёк данные статьи в 34 таблицы PostgreSQL, а затем преобразовал их в граф с помощью отображения R2RML. Обе формы были подключены к агенту через MCP. Агент последовательно отвечал на 15 вопросов о статье тремя способами: только через SQL, только через SPARQL и с выбором из двух вариантов. Эксперимент проводился на трёх LLM с открытыми весами, которые можно развернуть локально.
Результаты показали, что SPARQL в среднем давал более точные ответы, особенно когда вопросы требовали связей между сущностями. Однако SQL выигрывал в скорости и простоте для агрегаций и фильтрации. Интересный момент: DeepSeek при попытке ответить через SQL сгенерировал SQL-инъекцию — это напоминание о безопасности при работе с агентами.
Критерии выбора языка запросов
Чтобы не ошибиться, оцените следующие факторы:
- Структура данных. Если данные хорошо ложатся в таблицы с чёткими связями «один ко многим», SQL будет проще. Если важны сложные связи и иерархии, граф и SPARQL дадут преимущество.
- Наличие онтологии. Граф без описания классов и свойств теряет преимущество. Если готовы поддерживать онтологию, SPARQL может повысить точность.
- Типы вопросов. Для агрегатов и простых выборок SQL обычно быстрее. Для вопросов «как связаны X и Y» SPARQL выразительнее.
- Безопасность. Агент может генерировать опасные запросы. Ограничивайте права, используйте параметризацию и валидацию.
- Поддержка инструментов. Проверьте, какие библиотеки и MCP-серверы доступны для вашей LLM.
Типичные ошибки
Одна из главных ошибок — сравнивать «голый» SQL с графом, у которого есть онтология. Это неравные условия. Другая ошибка — игнорировать векторный поиск для семантических запросов. Автор также сравнивал lance и pgvector для векторного хранения; выбор зависит от нагрузки и требований к фильтрации. Третья ошибка — доверять агенту генерацию запросов без ограничений: как показал случай с DeepSeek, модель может пойти на инъекцию.
Как провести собственный эксперимент
Вот конкретные шаги:
- Соберите 10–20 вопросов, покрывающих разные типы запросов: фактические, агрегатные, связевые.
- Подготовьте две формы представления данных: реляционную и графовую с онтологией.
- Подключите обе к агенту через MCP или другой протокол.
- Запустите агента на нескольких LLM (например, с открытыми весами) и зафиксируйте точность, скорость и случаи ошибок.
- Проверьте безопасность: попробуйте спровоцировать генерацию опасных запросов.
Такой эксперимент даст вам факты, а не веру. Помните: не существует универсально лучшего языка — выбор зависит от данных, задач и готовности поддерживать онтологию.