Свёрточные нейронные сети (CNN) — один из самых практичных инструментов глубокого обучения. Если вы уже знакомы с базовыми понятиями (нейрон, слой, функция потерь, обратное распространение), самое время разобраться, как CNN обрабатывают изображения и не только. В этой статье — устройство CNN, ключевые компоненты, критерии выбора архитектуры и типичные ошибки новичков.
Зачем нужны свёртки, если есть полносвязные сети
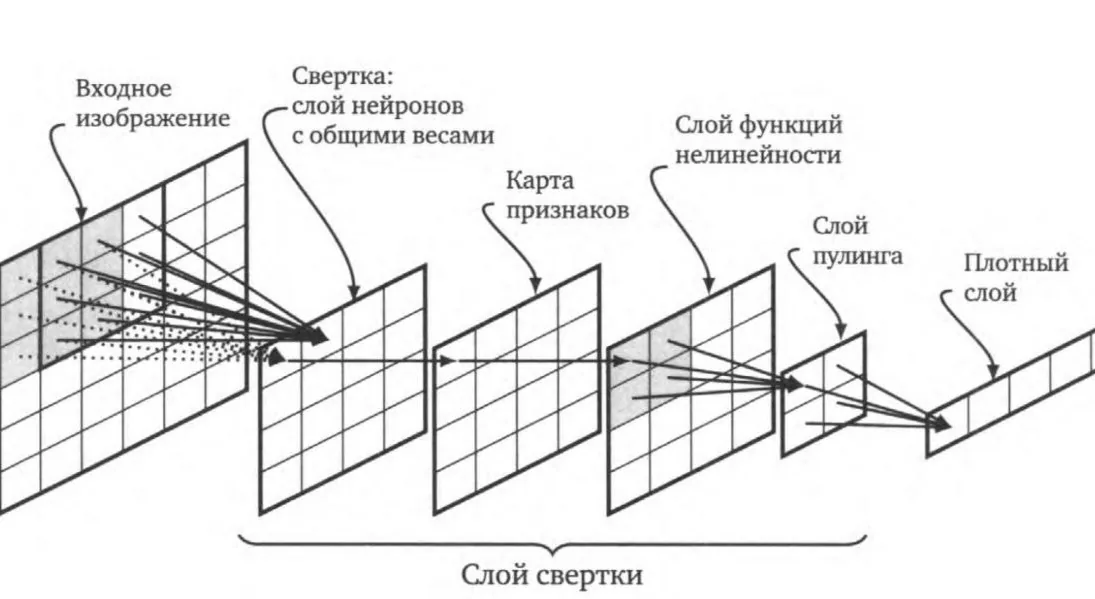
Полносвязная сеть на изображении 224×224×3 уже на первом слое потребует миллионы параметров. Это не только медленно, но и приводит к переобучению. Свёрточный слой решает две задачи: локальная связность (каждый нейрон смотрит на небольшой участок изображения) и разделение весов (одно и то же ядро скользит по всей картинке). Благодаря этому сеть учится распознавать простые паттерны — границы, углы, текстуры — независимо от их положения. Глубокие слои комбинируют эти паттерны в более сложные объекты.
Из чего состоит типичная CNN
Большинство современных свёрточных архитектур строятся по одной схеме: несколько блоков «свёртка → активация → пулинг», затем несколько полносвязных слоёв для классификации. Вот основные компоненты:
- Свёрточный слой — набор фильтров (ядер), каждый из которых выделяет свой признак. Размер ядра обычно 3×3 или 5×5, количество фильтров — гиперпараметр.
- Функция активации — чаще всего ReLU (или её варианты), добавляет нелинейность.
- Пулинг — уменьшает пространственные размеры, снижая вычислительную сложность и обеспечивая инвариантность к небольшим сдвигам. Max-pooling 2×2 — стандартный выбор.
- Полносвязные слои — в конце преобразуют карты признаков в вектор для классификации или регрессии.
- Нормализация — Batch Normalization или Layer Normalization помогают стабилизировать обучение.
Современные архитектуры (ResNet, EfficientNet) добавляют skip-connections и более сложные блоки, но базовая логика остаётся той же.
Как выбрать архитектуру под задачу
Не стоит сразу бросаться в сложные модели. Начните с простого бейзлайна и постепенно усложняйте. Вот критерии выбора:
- Размер датасета. Для небольших наборов (менее 10–20 тыс. изображений) лучше использовать предобученные модели (transfer learning) и замораживать свёрточные слои.
- Домен. Для медицинских снимков или спутниковых изображений может потребоваться адаптация архитектуры (например, изменение размера ядер или использование 3D-свёрток).
- Ресурсы. Если нет GPU, выбирайте лёгкие модели (MobileNet, SqueezeNet).
- Интерпретируемость. Если важно понимать, на что смотрит сеть, используйте методы визуализации (Grad-CAM) и архитектуры с вниманием.
Практический совет: начните с ResNet-18 или EfficientNet-B0, обученных на ImageNet, и дообучите на своих данных. Это часто даёт лучший результат, чем обучение с нуля.
Типичные ошибки и как их избежать
Даже опытные практики иногда допускают досадные промахи. Вот несколько распространённых:
- Неправильная нормализация данных. Если вы используете предобученную модель, приводите изображения к тому же распределению, на котором она обучалась (например, вычитание среднего и деление на стандартное отклонение ImageNet).
- Слишком большой learning rate. Свёрточные сети чувствительны к скорости обучения. Начните с 1e-3 и используйте scheduler (например, ReduceLROnPlateau).
- Игнорирование аугментации. Повороты, сдвиги, изменения яркости — простой способ улучшить обобщение без сбора новых данных.
- Переобучение из-за малого датасета. Добавьте dropout, weight decay и раннюю остановку. Следите за валидационной метрикой.
- Неправильная интерпретация пулинга. Max-pooling может терять информацию о точном положении объектов. В задачах сегментации или детекции часто используют stride-свёртки вместо пулинга.
Пример из практики: при классификации дефектов на производстве одна команда забыла про аугментацию и получила точность 95% на валидации, но 60% на реальных данных. Добавление поворотов и изменения контраста подняло реальную точность до 85%.
Что дальше
Свёрточные сети — это фундамент для многих современных приложений: от распознавания лиц до анализа медицинских изображений. Освоив базовые компоненты и типичные ошибки, вы сможете уверенно экспериментировать с архитектурами и применять transfer learning. В следующей части серии имеет смысл перейти к рекуррентным сетям и трансформерам, которые дополняют CNN в задачах обработки последовательностей. Практикуйтесь на открытых датасетах (CIFAR-10, ImageNet) и не бойтесь начинать с простых моделей.