Вокруг оптимизации под генеративный поиск (GEO, AEO, LLM Optimization) много противоречивых советов: от создания специальных текстовых файлов для языковых моделей до переписывания контента короткими абзацами фиксированной длины. Если сверить такие рекомендации с официальной документацией поисковых систем и архитектурой RAG (Retrieval-Augmented Generation), становится ясно: часть практик не влияет на индексацию, а некоторые прямо вредят показу сниппетов. Разберём инженерную механику генеративных блоков и соберём воспроизводимый чек-лист.
Как работают генеративные блоки в поиске
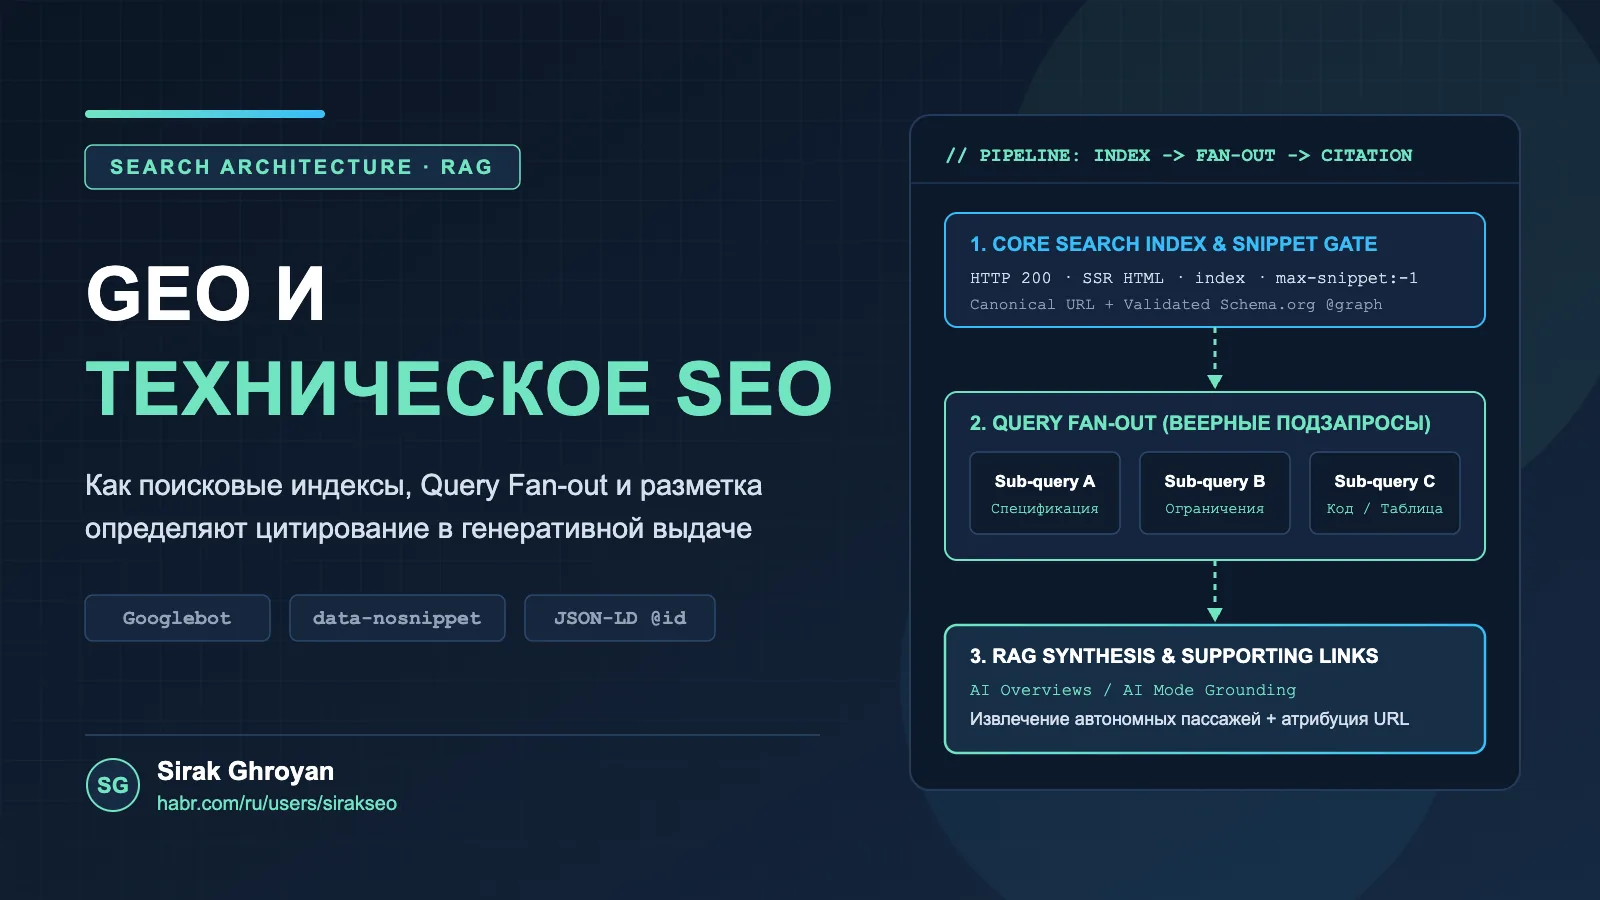
Google AI Overviews и AI Mode не «читают» весь интернет напрямую. Они используют существующий поисковый индекс, из которого извлекаются релевантные пассажи (фрагменты текста), а затем языковая модель формирует ответ. Ключевой этап — retrieval: поисковая система отбирает документы и фрагменты, которые с наибольшей вероятностью содержат ответ. Если страница не индексируется или её контент не разбивается на осмысленные пассажи, она не попадёт в генеративную выдачу. Таким образом, техническое SEO остаётся фундаментом: без правильной индексации и доступности контента никакие «оптимизации под LLM» не сработают.
RAG-конвейер включает два шага: поиск (retrieval) и генерацию. На этапе поиска важны классические сигналы: релевантность запросу, авторитетность домена, свежесть, структура страницы. На этапе генерации модель использует извлечённые пассажи как контекст. Чем яснее и полнее пассаж отвечает на вопрос, тем выше шанс, что именно его процитируют. Поэтому советы вроде «пишите короткими абзацами по 40 слов» не имеют подтверждения: длина абзаца не является фактором ранжирования, важнее логическая завершённость и соответствие интенту.
Мифы и реальные требования поисковых систем
Среди популярных мифов: создание файла llms.txt для языковых моделей, «оптимизация под GPT» через особые мета-теги, переписывание контента под «токенизацию». Официальная документация Google не упоминает подобные практики. Более того, некоторые действия могут навредить: например, закрытие страниц от индексации через noindex или запрет сниппетов в настройках max-snippet делает невозможным показ контента в генеративных блоках. Также не стоит полагаться на «секретные» файлы — поисковые роботы их игнорируют.
Что действительно задокументировано и влияет на попадание в AI-выдачу:
- Доступность для обхода: страница должна быть открыта для Googlebot (и других роботов, если речь о других поисковиках). Проверьте robots.txt, мета-теги robots, а также настройки CDN и файрвола.
- Индексация: страница должна быть в индексе. Используйте отчёт «Покрытие» в Search Console, чтобы убедиться, что нет ошибок.
- Качество контента: пассажи должны быть самодостаточными и отвечать на конкретные вопросы. Длинные простыни текста без подзаголовков хуже извлекаются.
- Структурированные данные: разметка Schema.org (JSON-LD) помогает поисковой системе понять сущности и связи, но не гарантирует цитирование. Однако она улучшает понимание контента.
- Сниппеты: не блокируйте показ сниппетов через max-snippet:0 или nosnippet — это может исключить ваш контент из генеративных ответов.
Чек-лист технической проверки сайта
Чтобы оценить готовность сайта к генеративному поиску, пройдите по шагам:
- Проверьте индексацию: в Search Console посмотрите, сколько страниц в индексе, есть ли исключённые важные URL.
- Убедитесь в доступности: robots.txt не должен блокировать важные разделы; мета-тег robots не должен содержать noindex или none.
- Настройте сниппеты: в мета-теге robots не должно быть nosnippet или max-snippet:0. Для отдельных страниц можно использовать max-snippet:-1 (без ограничений).
- Добавьте структурированные данные: используйте JSON-LD для разметки статей, FAQ, организаций. Проверьте валидность через Rich Results Test.
- Оптимизируйте пассажи: каждый подраздел должен начинаться с краткого ответа на вопрос (1–2 предложения), затем детали. Избегайте местоимений без контекста.
- Следите за свежестью: обновляйте контент, указывайте дату публикации и обновления.
Эти шаги не гарантируют цитирование, но устраняют технические барьеры и повышают вероятность, что ваш контент будет извлечён и использован.
Типичные ошибки и примеры
Ошибка 1: закрытие страниц от индексации в надежде, что «LLM прочитает напрямую». Языковые модели не обходят сайты самостоятельно; они используют поисковый индекс. Если страница закрыта, она не попадёт в RAG-конвейер.
Ошибка 2: переписывание контента под «оптимизацию для LLM» без учёта пользовательского опыта. Например, разбиение текста на множество мелких абзацев без логических связей ухудшает читаемость и не помогает извлечению. Лучше использовать чёткие подзаголовки и списки.
Ошибка 3: игнорирование структурированных данных. Хотя JSON-LD не является прямым фактором ранжирования, он помогает поисковым системам лучше понять сущности и связи, что может косвенно повлиять на выбор пассажа.
Пример: интернет-магазин добавил разметку Product с указанием цены и наличия. Это не гарантирует попадание в AI Overviews, но улучшает понимание страницы и может повысить шансы на цитирование в ответах о товарах.
Вместо поиска «секретных» методов сосредоточьтесь на технической гигиене и качестве контента. Генеративный поиск развивается, но его основа — классические принципы индексации и релевантности.