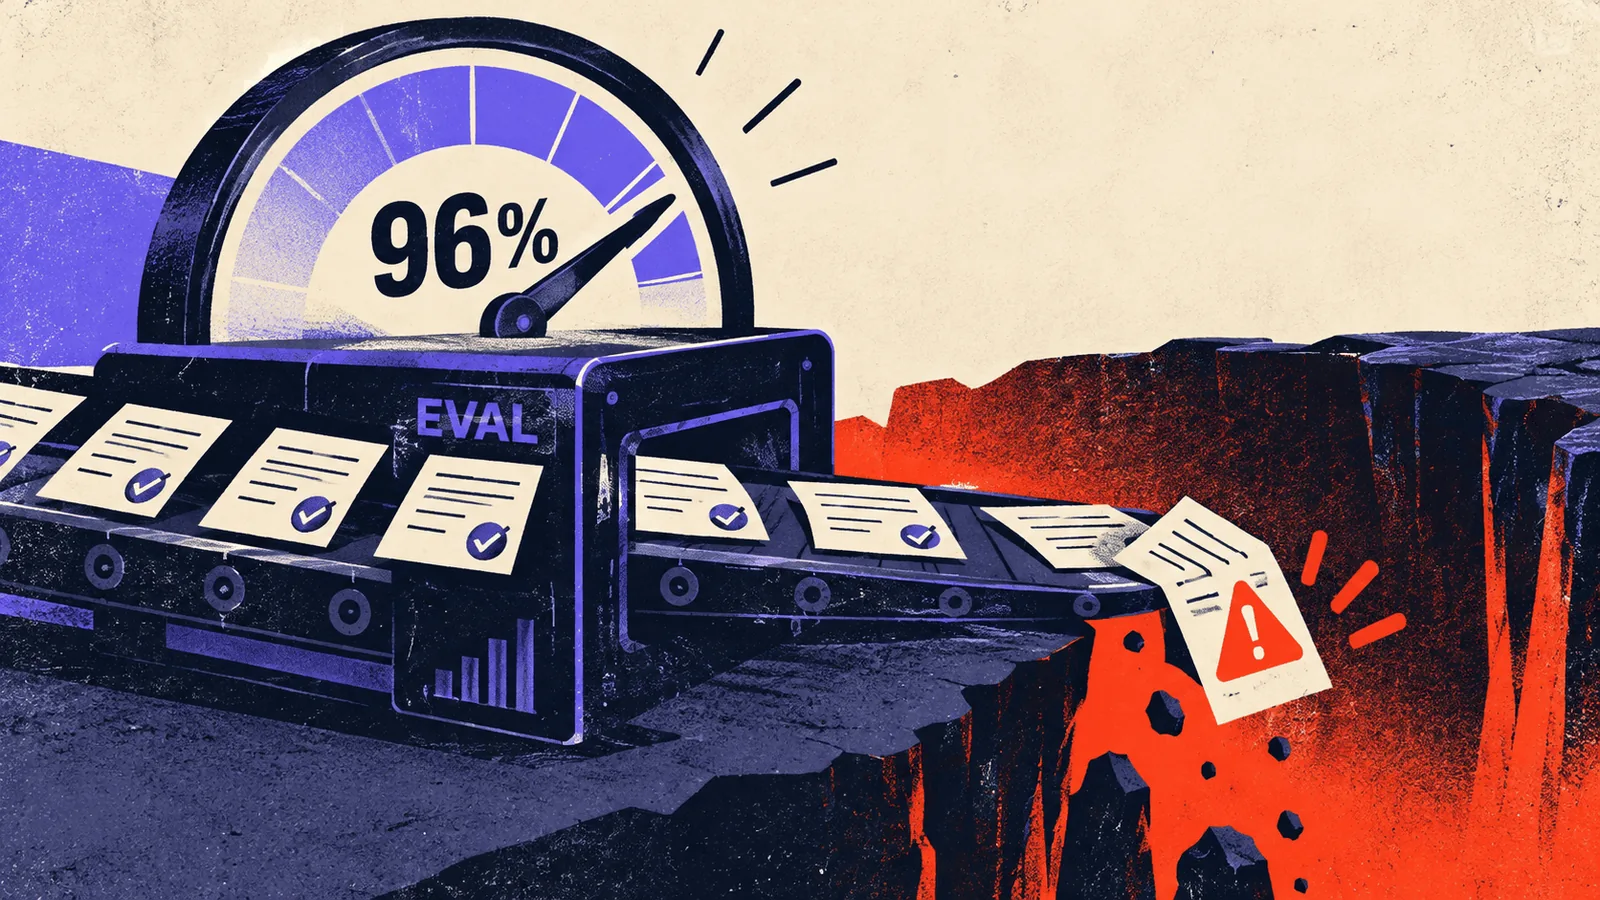
Высокий процент на eval — не гарантия качества LLM-фичи. Если система оценки пропускает опасные ответы, вы получаете ложное ощущение надёжности. Разберём типичные ошибки и шаги, которые помогут сделать eval полезным инструментом, а не формальностью.
Почему eval может обманывать
Eval — это модель того, как фича будет работать в реальности. Если тестовые данные не отражают реальные запросы, а метрики не учитывают критические ошибки, высокий процент ничего не значит. Например, оценка 96% может быть достигнута за счёт простых примеров, в то время как редкие, но важные случаи игнорируются.
Семь ошибок тестирования LLM-функций
- Смещение выборки: тестовые данные не репрезентативны — только «удобные» примеры.
- Игнорирование краевых случаев: редкие, но критичные запросы не включены в тесты.
- Оценка только по одному критерию: например, только точность, без учёта безопасности или релевантности.
- Отсутствие проверки на состязательные атаки: модель не тестируется на попытки обойти ограничения.
- Субъективность оценки: разметка зависит от одного эксперта или не имеет чётких критериев.
- Устаревшие тесты: данные не обновляются, модель деградирует на новых запросах.
- Игнорирование контекста: оценка ответа без учёта истории диалога или внешних данных.
Как построить eval, которому можно доверять
Начните с определения критических ошибок: что недопустимо в вашем продукте? Например, для ассистента поддержки — это неверная информация о возврате средств. Затем соберите тестовый набор, который включает как типичные, так и краевые случаи, а также примеры состязательных запросов. Используйте несколько метрик: точность, полнота, безопасность, релевантность. Привлекайте нескольких экспертов для разметки и проверяйте согласованность их оценок.
Практические шаги
- Определите список критических ошибок и их вес в итоговой оценке.
- Соберите репрезентативную выборку из реальных запросов, включая редкие и сложные.
- Добавьте состязательные примеры: попытки получить запрещённый контент, инъекции промптов.
- Используйте комбинацию автоматических метрик и экспертной оценки.
- Регулярно обновляйте тестовый набор и пересматривайте метрики.
- Внедрите мониторинг после релиза, чтобы отслеживать реальные ошибки.
Пример из практики
Предположим, вы тестируете LLM-ассистента для ответов на вопросы о банковских продуктах. Eval показывает 96% правильных ответов. Однако в тестах не было вопросов о досрочном закрытии вклада — редкого, но важного. После релиза ассистент дал неверную информацию, что привело к жалобам. Добавление таких случаев в eval и повышение их веса помогло бы выявить проблему до релиза.
Eval — не самоцель, а инструмент для принятия решений. Доверяйте ему, только если он учитывает ваши риски и построен на реальных данных.