Голосовые боты на больших языковых моделях (LLM) научились поддерживать беседу, но в реальных звонках они часто допускают ошибки: могут найти свободное окно и не записать клиента, перебить человека, который просто задумался, или неправильно понять короткую реплику. Причина в том, что LLM — генеративная модель, она хорошо составляет текст, но не всегда быстро и точно принимает решения о действии. Часть таких решений можно передать отдельному классификатору — быстрой модели, которая определяет намерение или состояние говорящего. Один из популярных вариантов — Jev от TypeSafe, но есть и открытые аналоги. В этой статье разберём, зачем нужен классификатор в голосовом боте на LLM, как его применять и каких ошибок избегать.
Почему LLM не хватает для надёжного диалога
LLM отлично генерирует ответы, но в голосовом боте важно не только что сказать, но и когда и как. Модель может «задуматься» над простым вопросом, выдать слишком длинную реплику или неверно интерпретировать паузу. В результате бот перебивает клиента, теряет контекст или пропускает важное действие, например, подтверждение записи. Кроме того, LLM чувствительна к формулировкам: одна и та же фраза, сказанная с разной интонацией, может привести к разным решениям. Это делает поведение бота непредсказуемым, а в продакшене непредсказуемость недопустима.
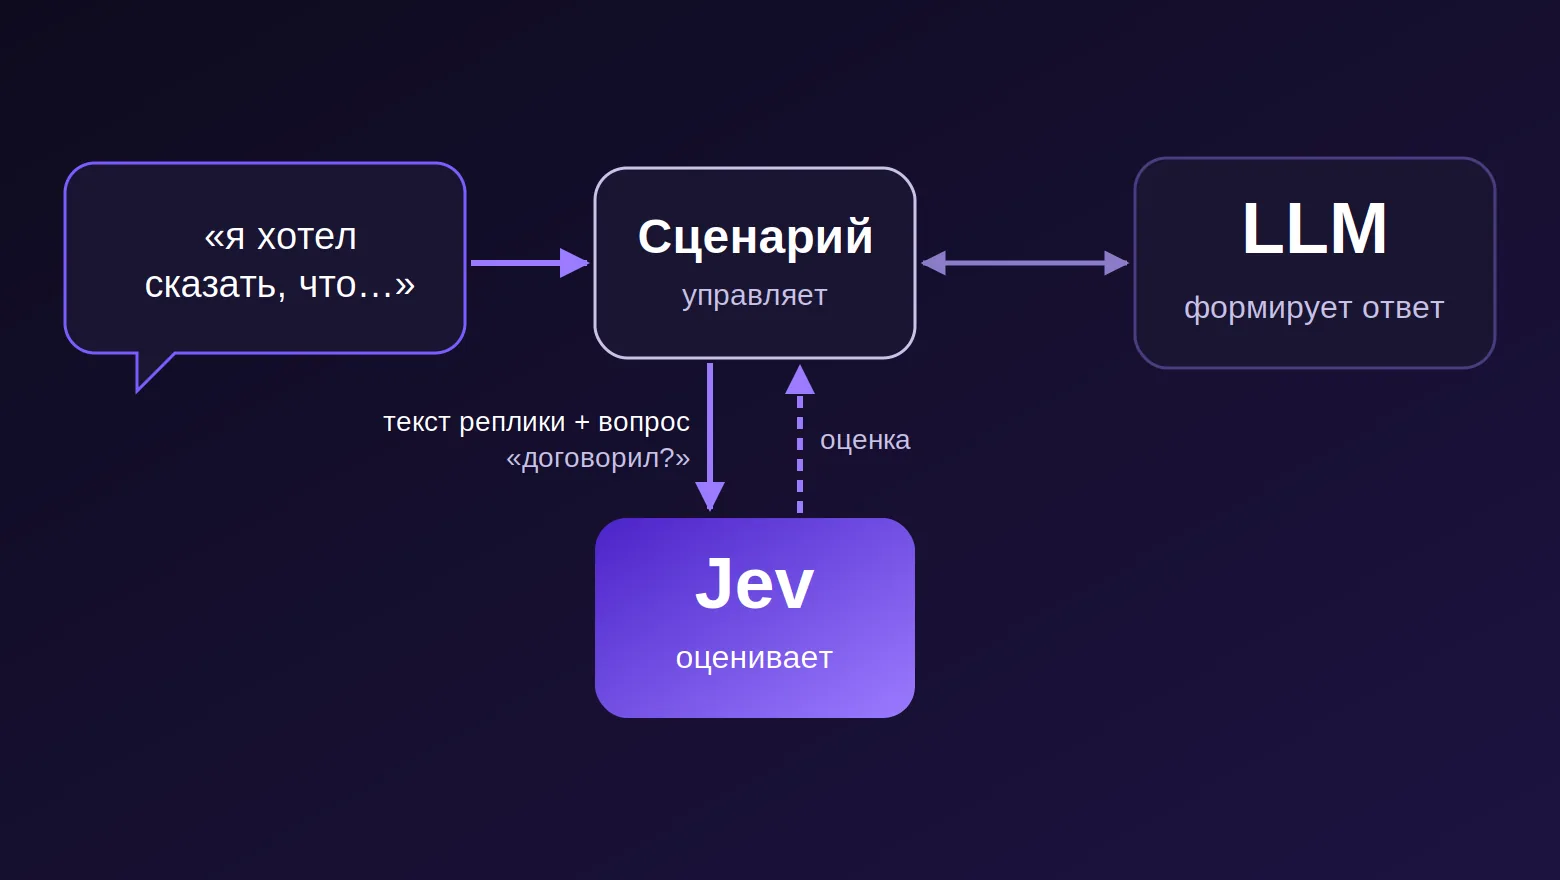
Классификатор решает эту проблему, беря на себя узкие задачи: определить, закончил ли пользователь говорить, какое намерение он выразил, нужно ли уточнить деталь. Такая модель работает быстро и стабильно, потому что обучена на конкретных примерах и не генерирует текст. LLM же остаётся для формулировки ответов и поддержания беседы.
Что умеет Jev и подобные классификаторы
Jev от TypeSafe — это модель, которая классифицирует реплики пользователя по заданным категориям. В голосовом боте её можно использовать для определения намерения (запись, вопрос, отказ), для детекции конца реплики (чтобы бот не перебивал), для выявления эмоционального состояния (раздражение, сомнение) и для проверки, содержит ли ответ необходимые данные (например, номер телефона). Jev не генерирует текст, а возвращает метку класса или вероятность, что позволяет боту принимать чёткие решения.
Помимо Jev, существуют открытые аналоги, например, модели на основе DistilBERT или других компактных архитектур, обученные на диалоговых данных. Их можно дообучить под конкретный сценарий. Выбор между готовым решением и собственной моделью зависит от задач и ресурсов.
Как встроить классификатор в голосового бота: пошаговый план
Внедрение классификатора требует продуманного подхода. Вот основные шаги:
- Определите задачи для классификатора. Не пытайтесь заменить LLM везде. Выделите 2–3 критичные функции: детекция конца реплики, распознавание намерения, проверка полноты данных. Начните с одной.
- Соберите и разметьте данные. Запишите реальные звонки (с согласия клиентов) и разметьте реплики по категориям. Если данных мало, используйте синтетические примеры, но проверяйте их на реальных звонках.
- Выберите модель. Для простых задач хватит компактной модели (например, логистической регрессии на эмбеддингах). Для сложных — Jev или открытый аналог. Оцените задержку: классификатор должен работать быстрее, чем LLM, иначе смысла нет.
- Обучите и протестируйте. Разделите данные на обучающую и тестовую выборки. Метрики — точность, полнота и F1 по каждой категории. Особое внимание — ложным срабатываниям, которые могут привести к перебиванию.
- Интегрируйте в диалоговый пайплайн. Классификатор должен вызываться параллельно с распознаванием речи, а его результат — влиять на логику бота: например, если классификатор уверен, что пользователь закончил, бот отвечает; если нет — ждёт.
- Мониторьте и дообучайте. В продакшене собирайте логи ошибок и периодически дообучайте модель на новых данных.
Типичные ошибки и как их избежать
Одна из главных ошибок — пытаться классифицировать всё подряд. Если задач слишком много, модель становится сложной и медленной, а точность падает. Лучше сфокусироваться на узких, но важных решениях. Вторая ошибка — игнорировать задержку. Классификатор должен работать за миллисекунды, иначе он не поможет избежать перебивания. Третья — использовать только синтетические данные. Реальные звонки содержат шум, паузы, оговорки, которые не встретятся в сгенерированных примерах. Четвёртая — не тестировать на «пограничных» случаях: например, когда пользователь говорит «да, но…» или замолкает надолго. Наконец, не стоит полностью полагаться на классификатор: оставьте возможность для LLM перехватить управление в сложных ситуациях.
Пример из практики: в одном проекте бот на LLM часто перебивал клиентов, которые делали паузу перед ответом. После внедрения простого классификатора на основе временных признаков и эмбеддингов количество перебиваний снизилось, а удовлетворённость выросла. При этом LLM продолжала генерировать ответы, но решение о моменте ответа принимал классификатор.
Когда классификатор не нужен
Если ваш бот работает в узком сценарии с жёсткой логикой (например, только приём заявок с фиксированными вопросами), возможно, вам хватит правил и регулярных выражений. Классификатор оправдан, когда диалог свободный, много вариантов развития и важна скорость реакции. Также не стоит внедрять классификатор, если у вас нет данных для его обучения и возможности их собирать — в этом случае начните с сбора логов и разметки.
В итоге, классификатор вроде Jev — это не замена LLM, а дополнение, которое делает голосового бота более предсказуемым и удобным. Начните с одной задачи, измерьте эффект и постепенно расширяйте. Главное — не усложнять без необходимости и всегда проверять решения на реальных звонках.