Недавний инцидент с дата-центрами Яндекса показал: даже крупные облачные провайдеры не застрахованы от сбоев. Несколько площадок пришлось остановить, и Yandex Cloud какое-то время работал в ограниченном режиме. Для клиентов, чьи ресурсы размещались на затронутых площадках, это означало необходимость заново поднимать инфраструктуру — внутри облака или у другого провайдера. Во многих компаниях эту работу выполняет DevOps-команда.
Кто за что отвечает
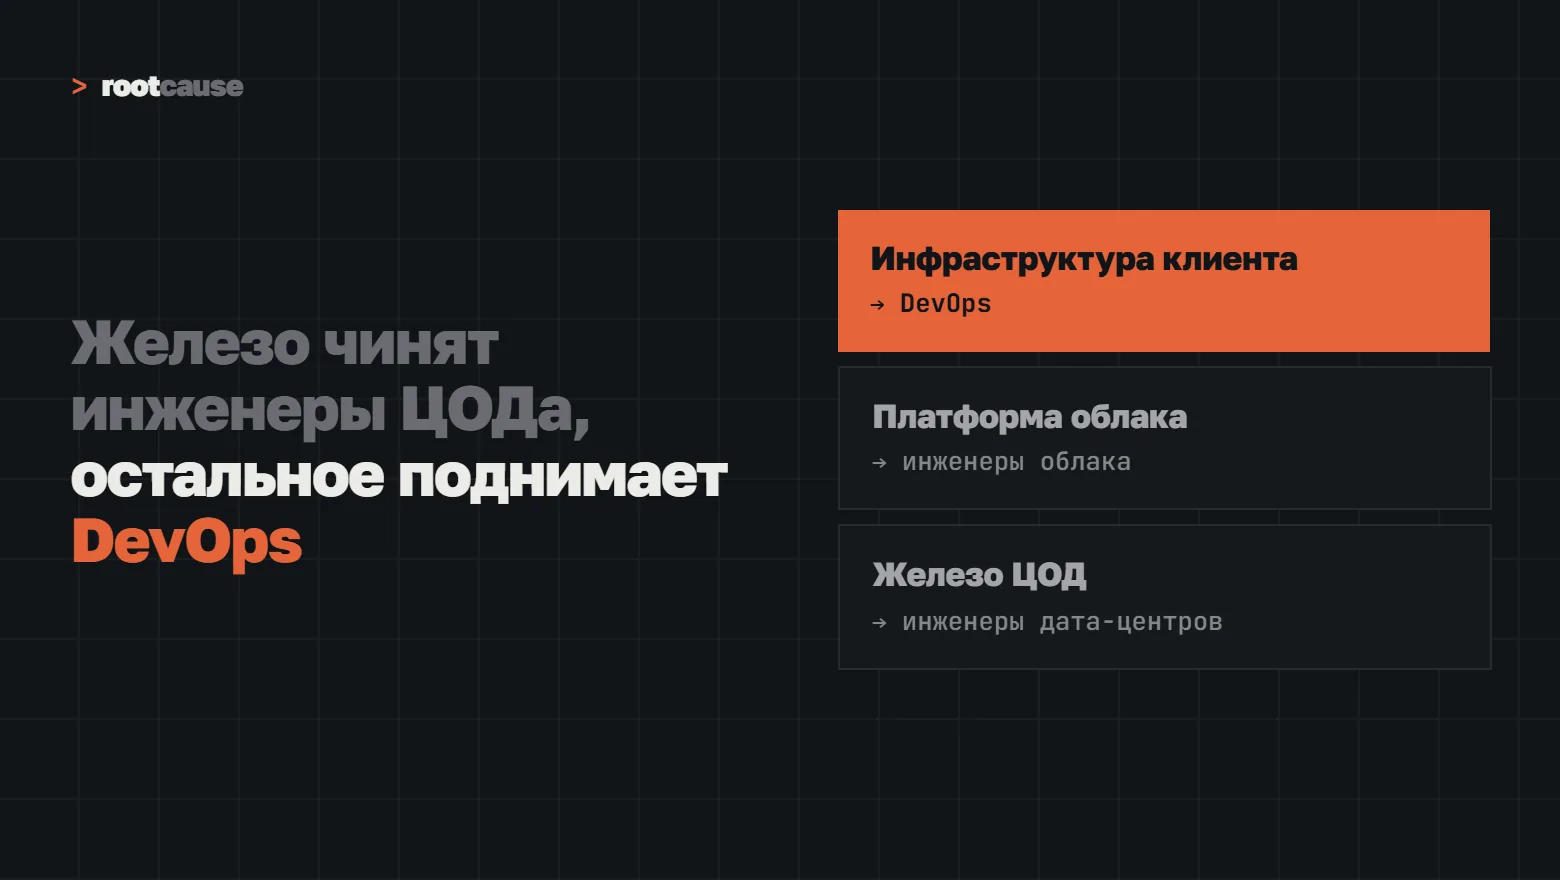
Важно понимать разделение зон ответственности. Инженеры ЦОД (центра обработки данных) отвечают за физическое оборудование: серверы, сети, системы охлаждения и электропитания. Их задача — обеспечить бесперебойную работу «железа». DevOps-команда, в свою очередь, отвечает за программную инфраструктуру: конфигурацию сервисов, оркестрацию, автоматизацию развёртывания и мониторинг. При сбое на стороне провайдера именно DevOps-специалисты занимаются восстановлением работоспособности приложений и данных.
Что делать DevOps-команде при сбое провайдера
Действия зависят от того, насколько инфраструктура готова к подобным ситуациям. Вот ключевые шаги, которые помогут снизить простои и потери.
- Оцените масштаб. Определите, какие сервисы и данные затронуты, какие площадки недоступны. Используйте мониторинг и логи, чтобы получить полную картину.
- Активируйте план восстановления. Если у вас есть резервные копии и заранее подготовленные конфигурации (например, Terraform-манифесты или Helm-чарты), разверните инфраструктуру в другом регионе или у другого провайдера. Проверьте, что все зависимости (базы данных, очереди, секреты) доступны.
- Переключите трафик. Обновите DNS-записи или настройки балансировщика, чтобы направить пользователей на работающие ресурсы. Убедитесь, что TTL записей позволяет быстро внести изменения.
- Проверьте целостность данных. После восстановления убедитесь, что данные не повреждены и соответствуют последней согласованной точке восстановления. При необходимости выполните восстановление из резервных копий.
- Задокументируйте инцидент. Зафиксируйте, что сработало, а что нет, чтобы улучшить план восстановления на будущее.
Критерии готовности к сбоям
Чтобы минимизировать последствия, инфраструктура должна соответствовать нескольким критериям. Вот на что стоит обратить внимание:
- Резервное копирование. Регулярные бэкапы критичных данных с проверкой возможности восстановления. Храните копии в разных географических регионах.
- Инфраструктура как код. Все конфигурации должны быть описаны в коде и храниться в репозитории. Это позволяет быстро развернуть окружение с нуля.
- Мультиоблачность или гибридная схема. Если критично непрерывность, рассмотрите возможность использования нескольких провайдеров или собственного оборудования для ключевых сервисов.
- Автоматизация развёртывания. Процессы сборки, тестирования и доставки должны быть автоматизированы, чтобы сократить время восстановления.
- Мониторинг и алертинг. Настройте оповещения о недоступности сервисов и аномалиях, чтобы быстро реагировать на проблемы.
Пример из практики
Предположим, компания размещает веб-приложение в облаке и использует управляемую базу данных. При сбое площадки провайдера приложение становится недоступным. Если у команды есть Terraform-конфигурация для развёртывания в другом регионе и резервная копия базы данных, они могут:
- Развернуть новое окружение в резервном регионе с помощью Terraform.
- Восстановить базу данных из последней резервной копии.
- Переключить DNS на новый балансировщик.
- Проверить работу приложения и сообщить пользователям о восстановлении.
Время восстановления зависит от подготовки: если всё автоматизировано, процесс может занять минуты или часы, а не дни.
Вывод
Сбои у провайдеров случаются, и полностью исключить их нельзя. Задача DevOps-команды — быть готовой к таким ситуациям: иметь актуальные резервные копии, инфраструктуру как код и отработанный план восстановления. Регулярно проверяйте свои процедуры на учениях, чтобы в реальной ситуации действовать быстро и слаженно.