Когда речь заходит о языке, у которого почти нет цифровых текстов, первая реакция — «значит, ничего не сделать». На практике это не так, но и волшебной кнопки нет. В этой статье — разбор стратегий, которые позволяют собрать пригодный для обучения корпус: от ручного сбора текстов до псевдоразметки двумя моделями. Все примеры и порядки величин взяты из реальных проектов, но без привязки к конкретным источникам и без раскрытия внутренних скриптов.
Слой первый: тексты, которые уже есть, но не в интернете
Самый надёжный источник — оцифрованные, но не опубликованные тексты: книги, газеты, архивы, методички. Их не найти поиском, но они существуют в виде сканов или PDF. Задача — организовать их сбор и обработку. Начните с инвентаризации: обзвоните библиотеки, вузы, культурные центры, спросите у сообщества. Даже 50–100 страниц в месяц дают ощутимый прирост за год. Далее — OCR. Для языков с латиницей или кириллицей подойдут открытые движки, но обязательно проверяйте качество на контрольной выборке: ошибки OCR бьют по морфологии и лексике. Например, в одном проекте после распознавания 200 страниц доля ошибок в словах достигала 15%, что потребовало ручной коррекции.
Типичная ошибка — сразу браться за всё. Лучше выделить 2–3 типа текстов (художественная литература, новости, бытовая переписка) и добиться на них стабильного качества. Не гонитесь за объёмом в ущерб чистоте: 10 тысяч грязных предложений хуже, чем 2 тысячи вычитанных.
Слой второй: близкородственные языки и «подмены»
Если язык близок к другому, у которого данных много, можно использовать частичный перенос. Например, для крымскотатарского часто смотрят в сторону турецкого: лексика пересекается, но грамматика и орфография отличаются. Простой подход — взять турецкий корпус и заменить слова по словарю соответствий. Это даёт стартовый объём, но требует осторожности. Во-первых, словарь должен покрывать не только частотные слова, но и служебные морфемы. Во-вторых, после подмены нужна фильтрация: модель-классификатор или простое правило «предложение должно содержать только символы целевого алфавита» отсеивает мусор.
В одном эксперименте после турецкой подмены и фильтрации осталось около 60% исходных предложений. Из них вручную проверили 500 — доля грамматически приемлемых составила примерно 70%. Это уже можно использовать как дополнительный слой, но не как единственный источник. Важно: не выдавайте такие данные за «естественные» — помечайте их как синтетические, чтобы не искажать оценку качества.
Слой третий: псевдоразметка двумя моделями
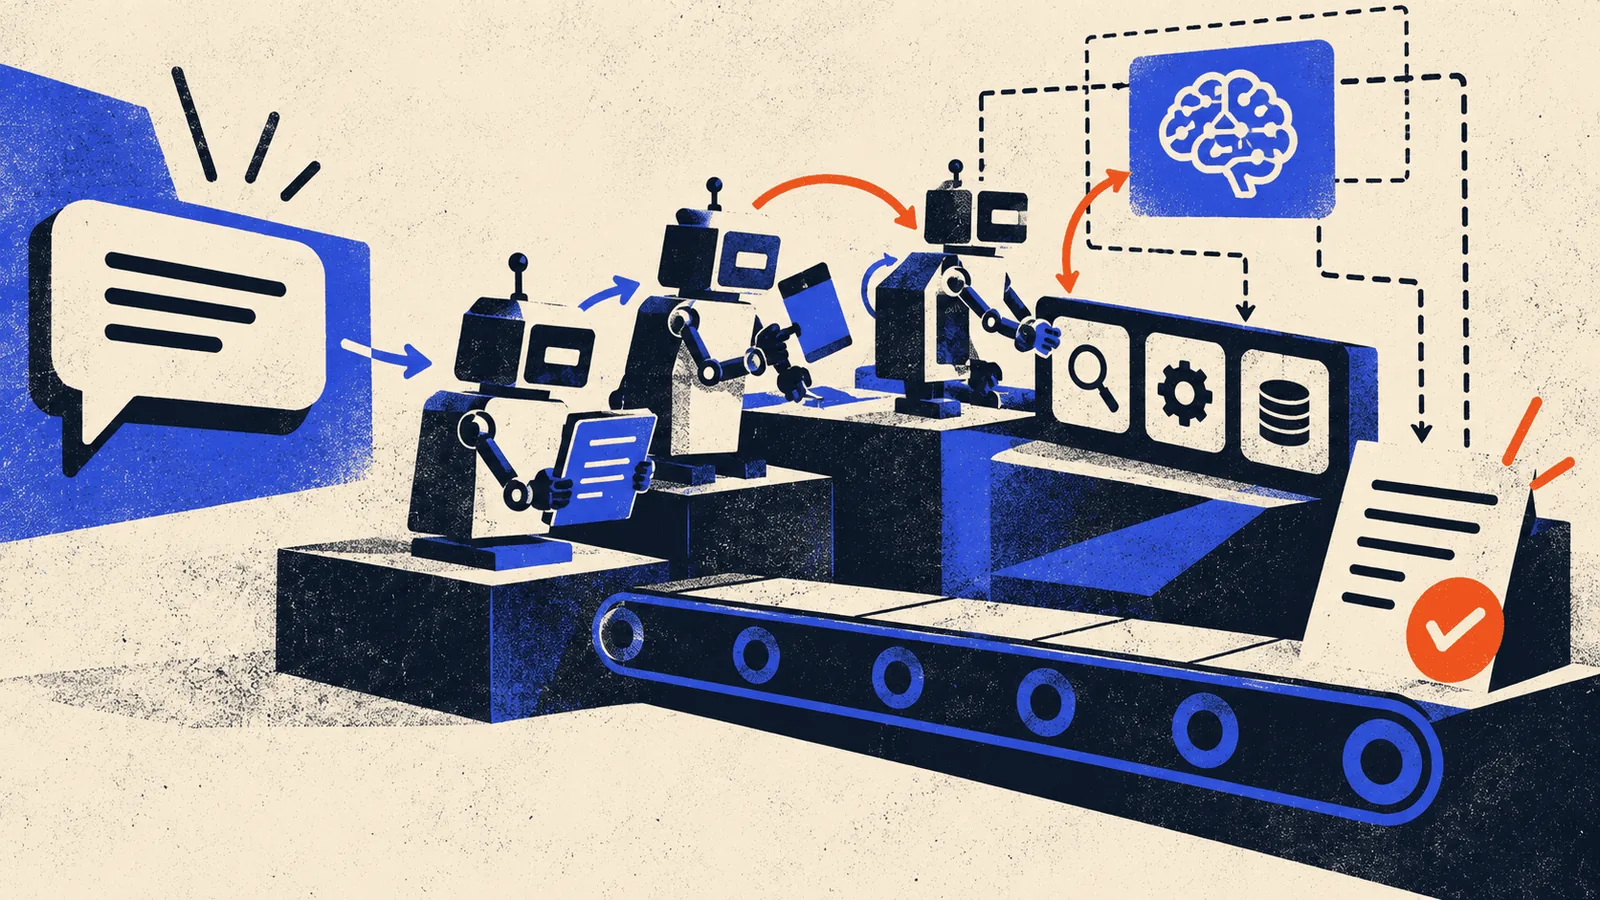
Когда есть небольшой чистый корпус (скажем, 5–10 тысяч предложений), можно расширить его с помощью псевдоразметки. Идея: обучить две разные модели (например, на разных архитектурах или с разными гиперпараметрами) на имеющихся данных, затем прогнать их по неразмеченному тексту (собранному из интернета или оцифровке). Предложения, на которых обе модели дают согласованный и уверенный ответ, добавляются в обучающий набор. Это снижает шум по сравнению с одной моделью.
Критерии отбора: порог уверенности (например, вероятность выше 0.9) и согласие между моделями. В одном проекте такой отбор дал прирост размеченных данных в 3–4 раза, а качество итоговой модели выросло на 5–7% по метрике F1. Но есть подвох: если модели ошибаются одинаково, ошибка закрепляется. Поэтому обязательно нужна ручная проверка случайной выборки из псевдоразмеченных данных — хотя бы 200–300 примеров. Если доля ошибок выше 10%, порог стоит поднять или сменить модели.
Метрики и контроль качества
Без метрик вы не поймёте, работает ли стратегия. Заведите простой дашборд: объём корпуса по слоям, доля отфильтрованных предложений, результаты ручной проверки, метрики обученной модели на отложенной выборке. Для каждого слоя фиксируйте происхождение и дату добавления. Это поможет отслеживать деградацию, если синтетика начинает доминировать.
- Чистота: доля предложений без орфографических и грамматических ошибок (по ручной оценке).
- Покрытие: доля слов из тестового списка, которые встречаются в корпусе хотя бы раз.
- Согласованность: для псевдоразметки — процент совпадений между двумя моделями.
- Валидация: метрика (например, перплексия или accuracy) на отложенной вручную размеченной выборке.
Типичная ошибка — оценивать только по объёму. Корпус в 100 тысяч предложений, из которых 80% — шум, хуже, чем 20 тысяч чистых. Также не забывайте про баланс жанров: если перекос в художественную литературу, модель будет плохо работать на бытовых запросах.
Что в итоге
Сбор данных для малоресурсного языка — это не один героический рывок, а комбинация трёх слоёв: оцифровка существующих текстов, аккуратные заимствования из близкородственных языков и псевдоразметка с перекрёстной проверкой. Каждый слой требует ручного контроля и честной маркировки. Начните с малого: соберите 500 чистых предложений, обучите простую модель, замерьте качество. Затем добавляйте следующий слой, каждый раз проверяя, не ухудшилась ли ситуация. Такой подход без обещаний «прорыва» даёт предсказуемый результат и понятные метрики.