Когда я решил сделать сервис, который по загруженному биту и теме генерирует рэп-куплеты, разложенные по тактам, я был уверен, что языковая модель справится. Достаточно дать ей BPM и попросить писать строки нужной длины. Первая версия выдавала что-то вроде школьных стихов под музыку: строки влезали в такт, но звучали как марш первоклассников. Причина — я путал количество слогов с флоу. Флоу — это не просто число слогов в строке, это ритмический рисунок, который должен совпадать с битом. В этой статье я расскажу, почему LLM не чувствует ритм, что пришлось считать самому и как я добился приемлемого результата на сервере с двумя ядрами и без видеокарты.
Почему языковая модель не чувствует бит
LLM обучены на текстах и предсказывают следующий токен, опираясь на статистику. Они отлично справляются с грамматикой, стилем и смыслом, но у них нет внутреннего метронома. Если попросить модель «написать 16 слогов на такт», она честно посчитает слоги, но расставит ударения и паузы так, как удобно языку, а не биту. В результате строка может содержать 16 слогов, но звучать будет как 12 или 20 — потому что часть слогов проглатывается, а часть растягивается. Модель не знает, что в рэпе важно не количество слогов, а их распределение по долям.
Кроме того, LLM не имеет доступа к аудио. Она не слышит бит и не может определить, где сильные доли, где слабые, а где брейк. Всё, что у неё есть, — это текстовое описание. Поэтому первая версия моего сервиса генерировала текст, который формально соответствовал числу слогов, но ритмически был бесполезен.
Что такое флоу на самом деле
Флоу — это манера исполнителя взаимодействовать с битом. Он включает в себя:
- Длительность слогов — одни слоги произносятся быстро, другие растягиваются.
- Ударения — смысловые акценты, которые часто попадают на сильные доли.
- Паузы — места, где исполнитель делает вдох или просто молчит.
- Синкопы — смещение акцентов с сильной доли на слабую.
Чтобы текст ложился на бит, нужно не просто посчитать слоги, а построить ритмический рисунок, который совместим с сеткой такта. Например, в такте 4/4 при 90 BPM одна доля длится примерно 667 мс. Если слог произносится за 150 мс, то в такт помещается около 4–5 слогов на долю, но это не значит, что они должны идти равномерно. Часто исполнители используют триоли, пунктирные ритмы и другие фигуры.
Как я считал ритм вручную
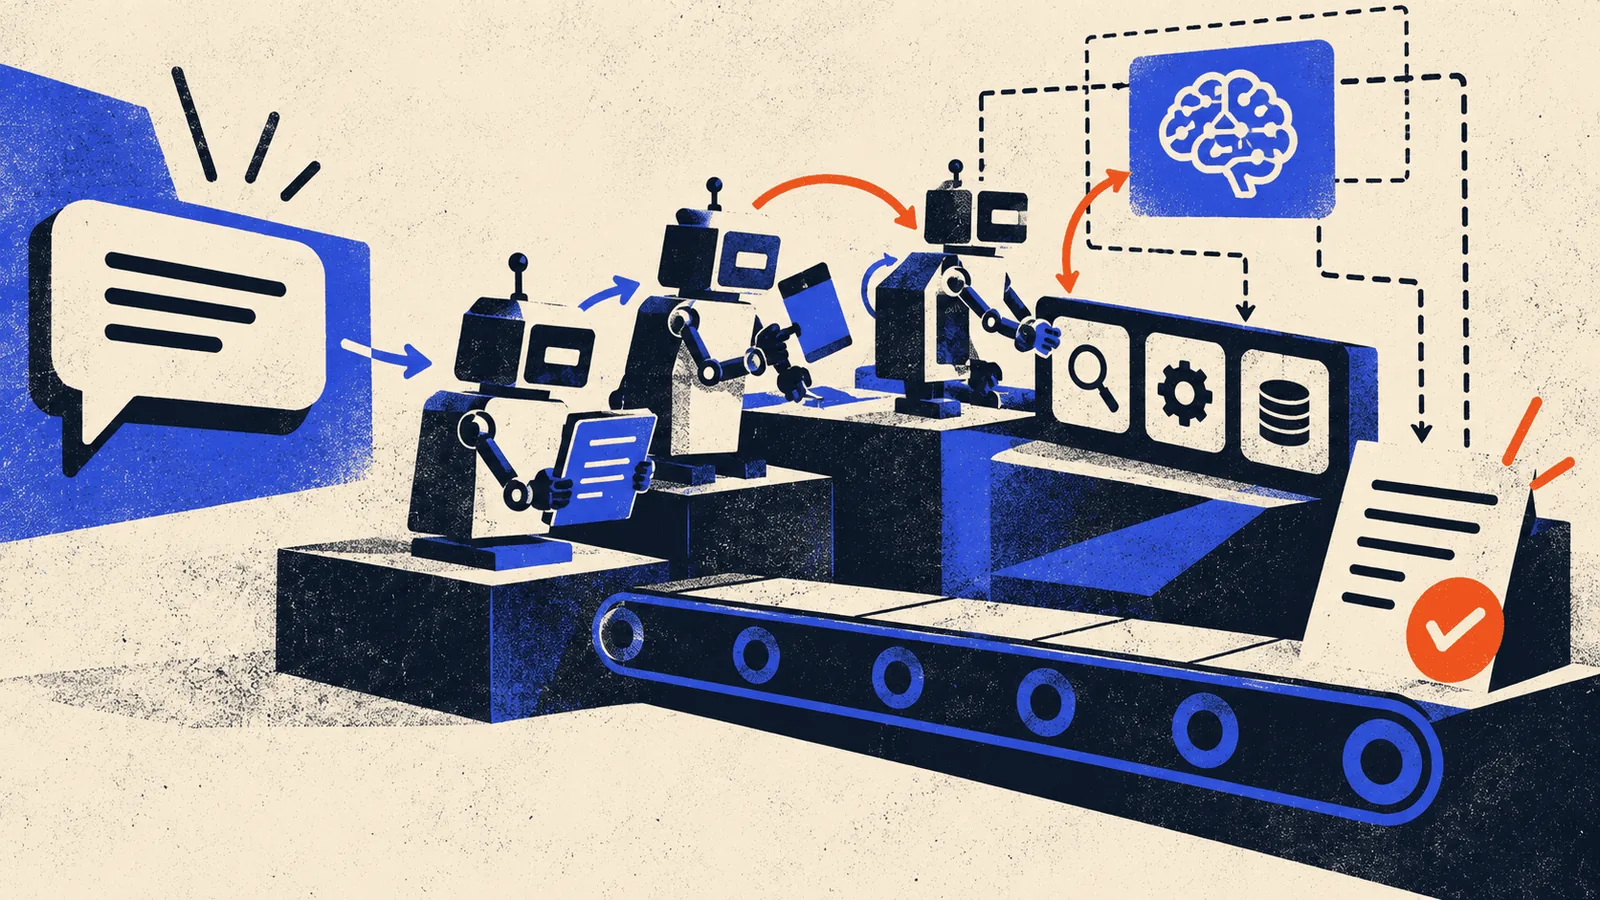
Поскольку модель не могла дать нужный результат, я решил вынести расчёт ритма в отдельный модуль. Вот шаги, которые я предпринял:
- Анализ бита. Я использовал библиотеку для определения BPM и выделения сильных долей. На слабом сервере это заняло больше времени, но оказалось выполнимым.
- Разметка слогов. Для каждого сгенерированного слова я вычислял количество слогов и их примерную длительность на основе фонетических правил (гласные, согласные, ударение).
- Построение сетки. Я разбил такт на 16 шестнадцатых долей и для каждой доли определил, может ли на ней начинаться слог.
- Оптимизация. С помощью простого алгоритма динамического программирования я подбирал такое распределение слогов по долям, чтобы суммарная длительность не превышала такт и акценты попадали на сильные доли.
Этот подход позволил генерировать текст, который действительно звучал в такт. Модель я использовал только для создания смыслового содержания, а ритмическую структуру задавал сам.
Типичные ошибки и как их избежать
В процессе я наступил на несколько грабель, которые стоит упомянуть:
- Игнорирование пауз. Сначала я считал, что все слоги должны быть произнесены, но в рэпе паузы так же важны, как и звуки. Без пауз текст звучит как скороговорка.
- Равномерное распределение. Если все слоги имеют одинаковую длительность, получается монотонно. Нужно варьировать длительность в зависимости от ударения и смысла.
- Пренебрежение ударениями. Русский язык имеет подвижное ударение, и если акцент падает не на сильную долю, это режет слух. Я добавил проверку, чтобы ударные слоги по возможности совпадали с сильными долями.
- Слишком сложная модель. Поначалу я пытался использовать нейросетевые модели для предсказания длительности слогов, но на слабом железе это было неэффективно. Простые эвристики работают не хуже.
Также важно не забывать, что рэп — это не только ритм, но и смысл. Если текст технически идеально ложится на бит, но не имеет содержания, это не рэп, а набор слогов.
Что в итоге получилось
После доработки сервис стал выдавать куплеты, которые при наложении на бит звучат как осмысленный рэп. Конечно, это не заменяет живого исполнителя, но для генерации черновиков или идей подходит. Главный вывод: языковая модель — мощный инструмент для работы с текстом, но ритм и музыкальную структуру лучше доверить алгоритмам. Если вы хотите повторить мой опыт, начните с простого: определите BPM, разбейте такт на доли и научитесь считать длительность слогов. И не бойтесь считать вручную — это надёжнее, чем надеяться на то, что модель сама разберётся.