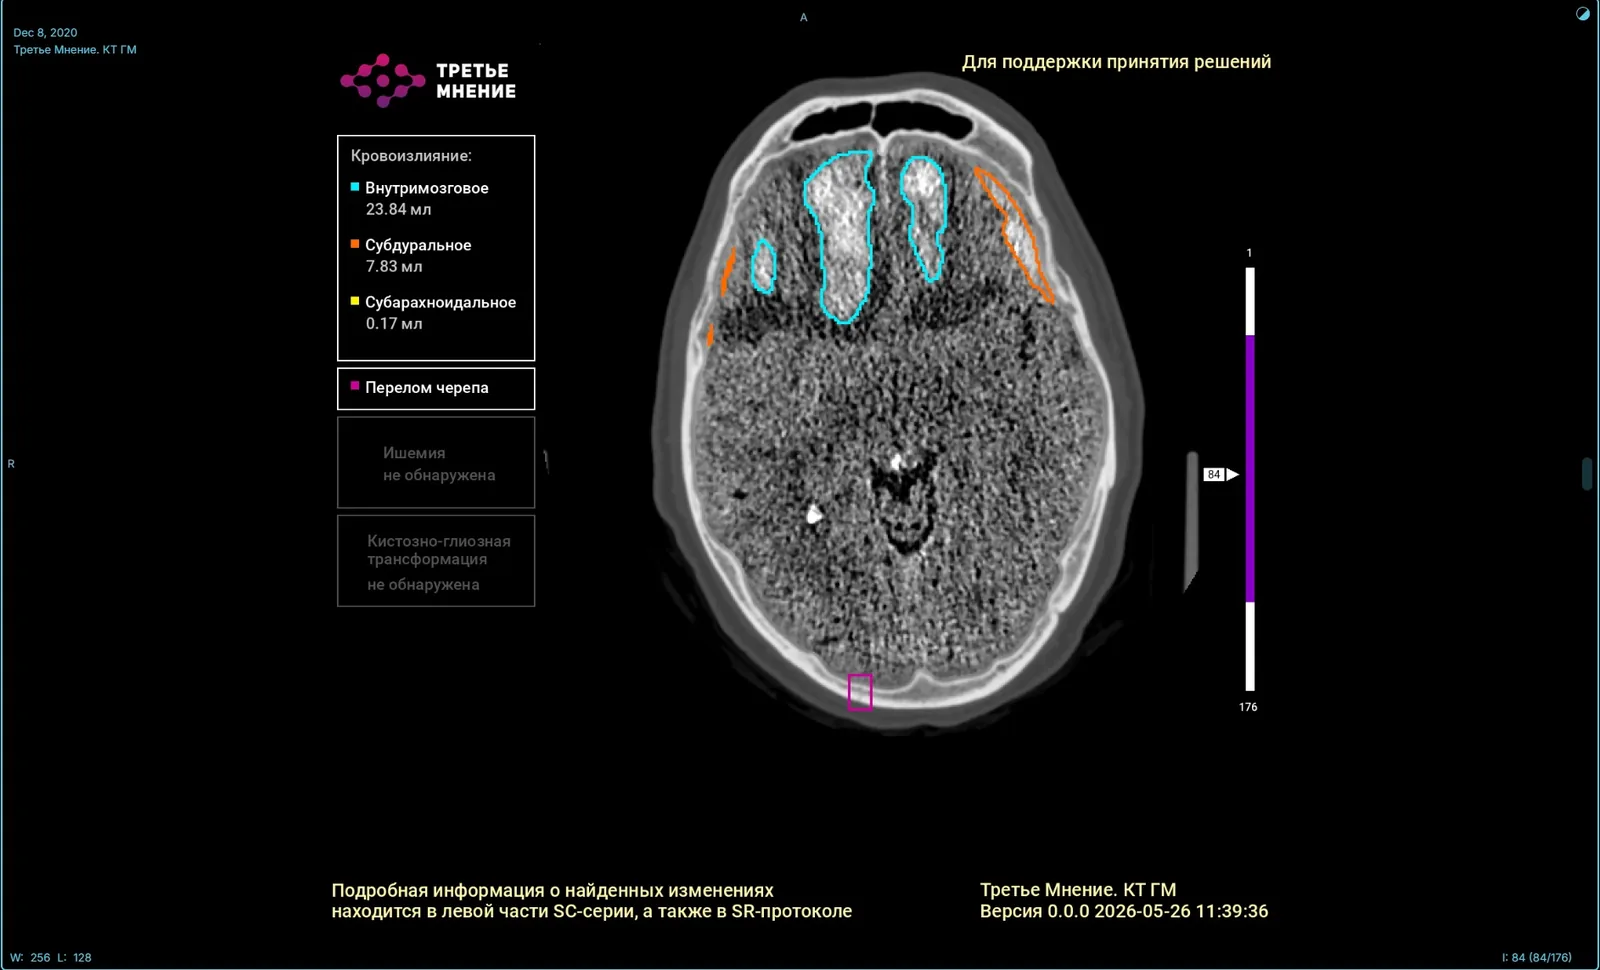
Медицинские изображения — это тяжёлые данные: рентген, флюорография, КТ и маммография требуют не только точных моделей компьютерного зрения, но и эффективной инфраструктуры. Когда поток исследований растёт, последовательная обработка на одной машине становится узким местом. В этой статье разберём, как подойти к масштабированию с помощью Ray, какие шаги предпринять и какие ошибки встречаются чаще всего. Материал основан на опыте ML-команды, которая обрабатывает лучевые исследования и возвращает клиникам результаты с находками, измерениями и оценками вероятности патологий.
Почему стандартные подходы перестают работать
На старте многие команды запускают обработку снимков в одном процессе или через простые очереди. Пока исследований десятки в день, этого достаточно. Но с ростом нагрузки появляются проблемы: GPU простаивают между задачами, предобработка изображений занимает больше времени, чем инференс, а падение одного этапа останавливает весь конвейер. Кроме того, медицинские данные требуют аккуратной работы с памятью — КТ-серии могут занимать гигабайты, и загружать их целиком в память каждого воркера нерационально. Ray предлагает модель распределённых вычислений, которая позволяет описывать задачи как удалённые функции и управлять ресурсами (CPU, GPU, память) на уровне кластера. Это не «серебряная пуля», но хороший инструмент для гетерогенных пайплайнов, где сочетаются предобработка на CPU и инференс на GPU.
С чего начать: аудит пайплайна и постановка задачи
Прежде чем внедрять Ray, зафиксируйте текущие метрики: сколько исследований в час обрабатывается, сколько времени занимает каждый этап (загрузка, предобработка, инференс, постобработка), где возникают задержки. Разбейте пайплайн на независимые шаги. Например, загрузка и декодирование DICOM, нормализация, прогон через модель, формирование отчёта. Для каждого шага определите тип ресурсов: предобработка обычно упирается в CPU и диск, инференс — в GPU. Это поможет понять, какие части имеет смысл распараллелить. Типичная ошибка — пытаться распараллелить всё сразу, не измерив узкие места. Начните с одного этапа, например с предобработки, и оцените выигрыш.
Ключевые шаги внедрения Ray
- Установите и настройте кластер. Для начала можно использовать локальный кластер Ray на нескольких машинах или в облаке. Убедитесь, что версии Ray и зависимостей совпадают на всех узлах.
- Опишите задачи как remote-функции. Разделите пайплайн на функции, которые можно выполнять независимо. Например, функция предобработки одного снимка и функция инференса. Используйте декоратор @ray.remote и указывайте ресурсы: num_cpus, num_gpus.
- Управляйте данными через object store. Передавайте между задачами не сами изображения, а ссылки на объекты в распределённом хранилище Ray. Это снижает нагрузку на сеть и память.
- Настройте политику повторных попыток. Медицинские данные не должны теряться при сбоях. Укажите max_retries для критичных задач и логируйте ошибки.
- Добавьте мониторинг. Используйте дашборд Ray и внешние системы (Prometheus, Grafana), чтобы отслеживать загрузку GPU, очередь задач и время выполнения.
Эти шаги позволяют постепенно перевести пайплайн на распределённую архитектуру без остановки текущих процессов.
Критерии выбора и типичные ошибки
Ray подходит не всегда. Если у вас стабильный поток из нескольких исследований в минуту и одна GPU, возможно, хватит простого асинхронного сервера. Ray оправдан, когда нужно гибко масштабировать разнородные задачи, использовать несколько GPU и машин, а также при пиковых нагрузках. Среди типичных ошибок: чрезмерное дробление задач (оверхед на планирование превышает выигрыш), игнорирование ограничений памяти (object store переполняется, и задачи падают), отсутствие изоляции зависимостей (конфликты версий библиотек на узлах). Ещё одна ошибка — пытаться использовать Ray для синхронных запросов с жёстким SLA без буферизации: в таких случаях лучше подходит очередь с предсказуемой задержкой. Пример из практики: команда распараллелила предобработку КТ-серий, но забыла про кэширование промежуточных результатов. В итоге при повторных запросах одни и те же данные обрабатывались заново, что свело выигрыш к нулю. Решение — сохранять результаты в распределённое хранилище и проверять наличие перед запуском задачи.
В следующей части разберём конкретную архитектуру и примеры кода. А пока рекомендуем начать с аудита пайплайна, выделить один этап для пилота и измерить эффект. Не гонитесь за масштабом сразу — последовательное улучшение с контролем метрик даёт более устойчивый результат, чем резкий переход на новую технологию.