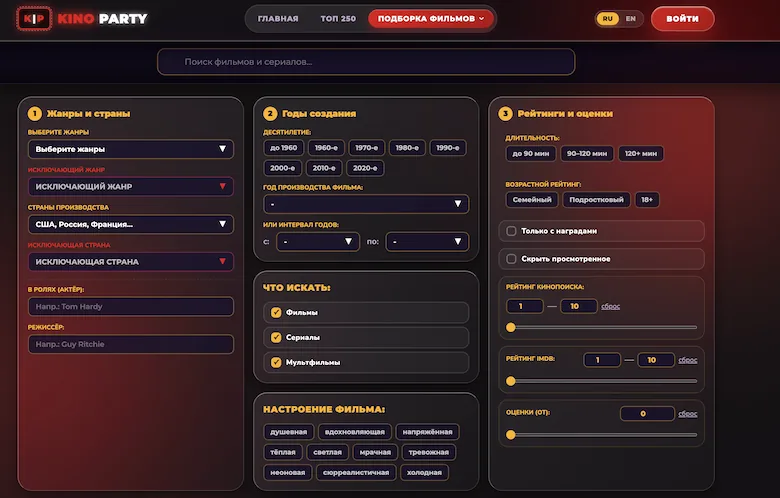
Вечер, компания друзей, желание посмотреть кино — и сорок минут листания каталогов стримингов. Персональные рекомендации не работают, когда фильм выбирает группа. В этой статье разберём, как устроен каталог фильмов и сериалов на 900 000 тайтлов с рекомендациями без нейросетей и ML-инфраструктуры: разрежённые векторы, косинусное сходство, инвертированный индекс, real-time комнаты кино-свайпера на SSE и честное SEO. Вы получите конкретные шаги, критерии выбора и описание типичных ошибок.
Архитектура и выбор технологий
Сервис построен на Node.js и SQLite. Такой стек позволяет быстро прототипировать и обрабатывать до 900 000 записей без отдельного сервера баз данных. Ключевые компоненты:
- Каталог тайтлов — таблица с метаданными (название, год, жанры, режиссёр, актёры, рейтинг).
- Разрежённые векторы — для каждого фильма строится вектор признаков (жанры, ключевые слова, актёры). Разрежённость экономит память и ускоряет вычисления.
- Косинусное сходство — метрика для поиска похожих фильмов. Вычисляется между векторами в реальном времени или кэшируется.
- Инвертированный индекс — для быстрого поиска по ключевым словам и жанрам.
- Real-time комнаты — на Server-Sent Events (SSE) для синхронизации свайпов между участниками.
Критерии выбора: простота развёртывания, отсутствие внешних зависимостей, скорость разработки. SQLite подходит для чтения-ориентированных нагрузок, но требует аккуратной работы с транзакциями при записи.
Построение рекомендаций на разрежённых векторах
Каждый фильм представляется вектором в пространстве признаков. Например, жанры кодируются как бинарные признаки, актёры и режиссёры — как взвешенные. Вектор разрежён: большинство признаков нулевые. Для хранения используйте разрежённые структуры (например, объекты с ненулевыми индексами).
Косинусное сходство между двумя векторами вычисляется как скалярное произведение, делённое на произведение длин. Для разрежённых векторов скалярное произведение эффективно вычислять через пересечение ненулевых индексов. Шаги:
- Нормализуйте векторы (приведите к единичной длине) при индексации.
- Для поиска похожих фильмов вычислите сходство с целевым вектором, отсортируйте и возьмите топ-N.
- Кэшируйте результаты для популярных запросов, чтобы избежать повторных вычислений.
Типичная ошибка — использовать плотные векторы для всех признаков, что приводит к раздуванию памяти. Другая ошибка — не нормализовать векторы, тогда косинусное сходство теряет смысл.
Инвертированный индекс для поиска и фильтрации
Инвертированный индекс сопоставляет каждое ключевое слово (жанр, актёр, тег) списку идентификаторов фильмов. Это позволяет быстро отвечать на запросы вроде «все фильмы с жанром комедия и актёром X». В SQLite можно реализовать через отдельную таблицу связей или использовать встроенный полнотекстовый поиск (FTS5).
Пример структуры: таблица inverted_index с полями term и movie_ids (JSON-массив). При поиске объединяйте списки для нескольких терминов (пересечение). Для больших объёмов данных храните инвертированный индекс в памяти при старте сервера — это ускорит запросы.
Критерии выбора: если поиск по ключевым словам критичен, используйте FTS5; если нужна гибкость с весами — самодельный индекс. Не забывайте про обновление индекса при добавлении новых фильмов.
Real-time комнаты на SSE и честное SEO
Для совместного выбора фильма используйте комнаты, где участники свайпают карточки. SSE (Server-Sent Events) — лёгкая альтернатива WebSocket для однонаправленной передачи событий от сервера к клиенту. Реализация:
- При подключении клиент получает уникальный ID комнаты.
- Сервер хранит состояние комнаты (список участников, текущий фильм, свайпы) в памяти или в SQLite.
- При действии одного участника сервер рассылает событие всем подключённым через SSE.
SSE проще в реализации, но не поддерживает двустороннюю связь — для отправки свайпов используйте обычные HTTP-запросы. Ошибка: держать состояние комнаты только в памяти — при перезапуске сервера данные теряются. Решение: периодически сохраняйте состояние в SQLite.
SEO: для индексации поисковиками используйте серверный рендеринг (SSR) или предварительную генерацию страниц фильмов с уникальными заголовками и описаниями. Избегайте дублирования контента, добавляйте микроразметку Schema.org. Не полагайтесь на клиентский рендеринг — поисковики могут не выполнять JavaScript.
Практические шаги и типичные ошибки
Чтобы повторить проект, начните с малого:
- Соберите каталог из открытых источников (например, IMDb datasets) и загрузите в SQLite.
- Реализуйте построение разрежённых векторов для каждого фильма (жанры, ключевые слова).
- Напишите функцию косинусного сходства и протестируйте на нескольких примерах.
- Добавьте инвертированный индекс для поиска по ключевым словам.
- Создайте простой интерфейс для свайпов и комнаты на SSE.
Типичные ошибки: избыточная нормализация признаков, игнорирование кэширования, отсутствие обработки ошибок при работе с SSE (обрывы соединения), пренебрежение SEO при динамическом контенте. Пример из практики: без кэширования косинусного сходства время ответа на запрос рекомендаций достигало 2 секунд; после кэширования топ-N для каждого фильма — снизилось до 50 мс.
В результате получается работающий сервис без ML-инфраструктуры, который решает проблему выбора фильма для компании. Главное — не усложнять и использовать простые математические инструменты.