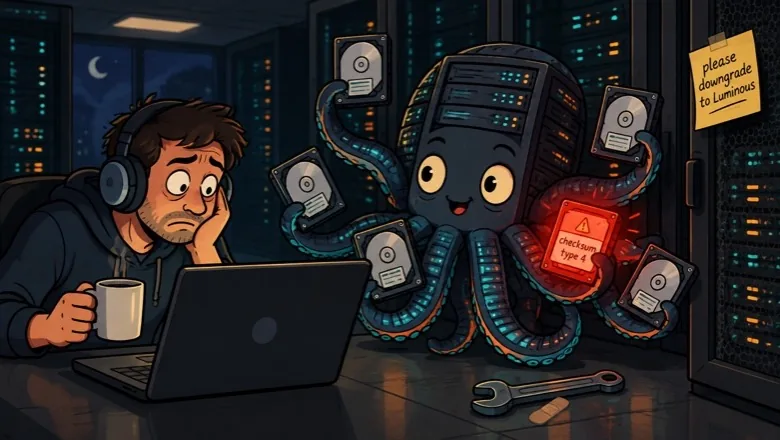
Администрирование Ceph — это баланс между автоматизацией и ручным вмешательством. История, которую я разберу, начинается с вечера, когда одиннадцать OSD упали, а одна неверная команда в cephadm shell добила ещё один. Данные не пострадали, но решардинг и знакомство с RocksDB заняли пару часов. Ниже — практический разбор без героики: что произошло, какие шаги помогли и какие правила стоит держать в голове.
Что случилось: цепочка событий
Сначала отказали одиннадцать OSD — причина может быть разной (сеть, диск, питание), но важно, что кластер перешёл в состояние degraded. Вместо того чтобы остановиться и собрать диагностику, я начал «чинить» вручную через cephadm shell. Одна из команд затронула метаданные OSD, и он перестал запускаться. Дальше — проверка контрольных сумм XXH3, попытки чтения из RocksDB и осознание, что база данных не может прочитать то, что сама записала. Это классическая ситуация: поспешные действия в shell без понимания последствий.
Диагностика: что проверять в первую очередь
Прежде чем что-то менять, нужно зафиксировать состояние. Вот минимальный набор шагов, который я рекомендую:
- Соберите статус кластера: ceph status, ceph osd tree, ceph health detail. Запишите вывод в файл.
- Проверьте логи OSD: journalctl -u ceph-osd@ или cephadm logs --name osd.. Ищите ошибки ввода-вывода и RocksDB.
- Оцените состояние дисков: smartctl, dmesg на предмет ошибок SCSI/NVMe.
- Не трогайте метаданные без бэкапа. Если OSD не стартует, сначала попробуйте перезапустить службу, а не лезть в RocksDB.
В моём случае ошибка была в том, что я пропустил этап сбора логов и сразу перешёл к «лечению». Это типичная ошибка: желание быстро вернуть кластер в норму приводит к дополнительным сбоям.
Решардинг как способ восстановления
После того как один OSD был добит, кластер стал ещё более несбалансированным. Решардинг (перераспределение PG) помог выровнять нагрузку и вернуть доступность данных. Но это не мгновенный процесс. Вот что важно учесть:
- Остановите лишние операции: отключите скрабинг и глубокую очистку на время восстановления (ceph osd set noscrub, ceph osd set nodeep-scrub).
- Управляйте скоростью решардинга: параметры osd_max_backfills, osd_recovery_max_active помогают не перегрузить кластер.
- Следите за состоянием PG: ceph pg stat и ceph pg dump покажут, какие PG в состоянии active+clean, а какие ещё восстанавливаются.
- Не удаляйте OSD сразу: если есть шанс восстановить данные, лучше временно вывести OSD из кластера (ceph osd out), чем уничтожать.
Решардинг не «лечит» сломанный OSD, но он позволяет кластеру продолжить работу с оставшимися дисками и перераспределить данные. В моём случае после решардинга удалось стабилизировать кластер и уже потом заняться восстановлением метаданных.
Типичные ошибки и правила, которые стоит знать заранее
Из этого инцидента я вынес три правила, которые рекомендую всем, кто работает с Ceph:
- Не выполняйте команды в cephadm shell без понимания. Даже если кажется, что команда безопасна, проверьте её на тестовом кластере или хотя бы изучите документацию.
- Всегда делайте бэкап метаданных OSD перед любыми манипуляциями. RocksDB можно повредить, и тогда восстановление будет сложным.
- Сначала диагностика, потом действия. Соберите логи, статус, проверьте контрольные суммы — и только потом что-то меняйте.
Ещё одна ошибка — игнорировать предупреждения кластера. Если Ceph сообщает о degraded PG, не стоит откладывать: чем дольше кластер в таком состоянии, тем выше риск потери данных.
В итоге данные не пострадали, но урок был усвоен. Теперь я всегда начинаю с ceph health detail и не трогаю OSD без чёткого плана. Надеюсь, этот разбор поможет вам избежать похожих граблей.