Заголовки вроде «LLM научились напрямую управлять мозгом другой LLM» звучат как научная фантастика. На деле речь идёт об исследовании MIT, где GPT-6 Astra пыталась предсказывать назначение модели по её весам и улучшать её поведение без дообучения. Звучит интригующе, но при внимательном чтении всё оказывается прозаичнее — и одновременно интереснее. Ниже — разбор того, что именно сделали исследователи, какие ограничения есть у метода и как аккуратно повторить эксперимент, не поддавшись хайпу.
Что на самом деле сделали исследователи
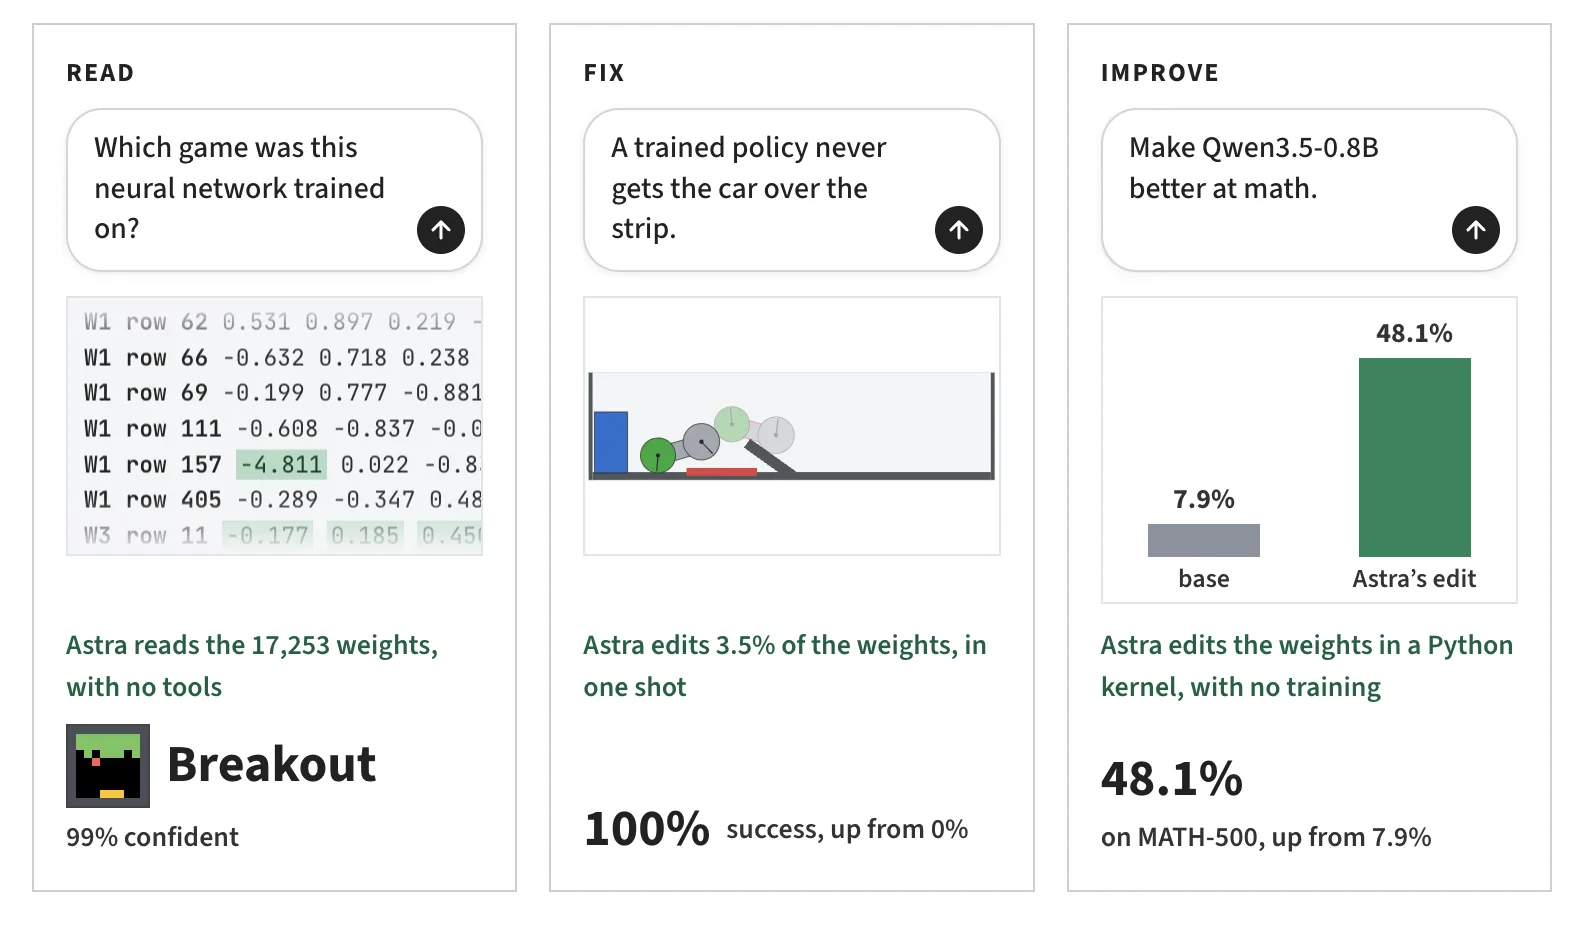
Авторы статьи показали, что большая языковая модель способна по одному только файлу весов другой модели сделать вывод о её специализации: например, что перед нами кодогенератор, чат-модель или модель для математики. Это не «чтение мыслей» и не прямой доступ к внутренним представлениям. Скорее, модель-анализатор учится на статистических закономерностях в массивах чисел, которые образуют веса. Во второй части эксперимента GPT-6 Astra предлагала изменения в весах, которые улучшали качество целевой модели на конкретных задачах — без градиентного обучения и без изменения архитектуры.
Ключевой момент: «улучшение без дообучения» не означает, что модель стала умнее вообще. Речь о точечной настройке, которая помогает на узком наборе примеров. В статье это подаётся как «нативное чтение и письмо на языке весов», но с практической точки зрения это скорее продвинутый метод анализа и редактирования параметров, а не универсальный инструмент.
Как это работает: три шага
Если убрать маркетинговую обёртку, процесс выглядит так:
- Сбор данных. Берутся пары «веса модели — её назначение или метрики качества». Это могут быть открытые модели с известными карточками или результаты собственных замеров.
- Обучение анализатора. Модель-анализатор (в эксперименте — GPT-6 Astra) учится предсказывать свойства целевой модели по её весам. Важно: анализатор не «видит» архитектуру, только числовые массивы.
- Генерация правок. На основе предсказаний анализатор предлагает изменения в весах. Эти правки проверяются на отложенной выборке задач — если метрики улучшаются, правки считаются полезными.
Никакого «прямого управления мозгом» здесь нет. Скорее, это похоже на то, как опытный инженер по звуку настраивает эквалайзер, не имея доступа к схеме усилителя: он действует по косвенным признакам и пробует разные комбинации.
Как повторить дома: практические шаги
Автор оригинального поста утверждает, что повторил эксперименты в домашних условиях. Если хотите проверить сами, вот реалистичный план:
- Выберите открытые модели. Возьмите 3–5 небольших моделей с разными специализациями (например, код, чат, математика). Убедитесь, что их веса доступны, а лицензия позволяет эксперименты.
- Соберите метаданные. Для каждой модели зафиксируйте задачу, на которой она обучалась, и базовые метрики на вашем тестовом наборе.
- Обучите простой классификатор. Не обязательно использовать GPT-6 Astra. Начните с линейной модели или небольшой нейросети, которая по усреднённым статистикам весов предсказывает специализацию. Это даст понимание, есть ли сигнал в данных.
- Перейдите к правкам. Если классификатор работает, попробуйте генерировать небольшие возмущения в весах и замерять эффект. Начните с одного слоя и узкой задачи — так проще интерпретировать результаты.
- Проверяйте на отложенной выборке. Любое улучшение должно подтверждаться на данных, которые не использовались при обучении анализатора. Иначе вы измеряете переобучение, а не пользу.
Не ждите, что получите универсальный инструмент. Скорее всего, эффект будет скромным и узким. Но сам процесс хорошо проясняет, как LLM работают с параметрами других моделей.
Типичные ошибки и ограничения
Главная ошибка — воспринимать заголовок буквально. «Чтение весов» не означает, что модель понимает смысл каждого числа. Она улавливает статистические паттерны, которые могут быть полезны для предсказания, но не дают полной картины. Вторая ошибка — ожидать, что правки весов заменят дообучение. На практике точечные изменения могут улучшить метрику на конкретном наборе, но ухудшить обобщение. Третья — игнорировать вычислительную стоимость: анализ весов большой модели требует значительных ресурсов, даже если не используется градиентное обучение.
Кроме того, метод чувствителен к архитектуре. Если анализатор обучался на трансформерах одного типа, он может плохо работать с другими. И наконец, не стоит забывать о безопасности: редактирование весов может непредсказуемо менять поведение модели, включая нежелательные эффекты.
Что это значит для практиков
Для большинства специалистов по данным и ML-инженеров этот метод пока остаётся исследовательским инструментом. Он полезен, если нужно быстро оценить специализацию модели по её весам или поэкспериментировать с тонкой настройкой без полного дообучения. Но в продакшене полагаться на него рискованно: нет гарантий стабильности, а интерпретируемость низкая.
Тем не менее, направление интересное. Оно подталкивает к вопросу: можно ли автоматизировать анализ и адаптацию моделей, используя другие модели в качестве «инспекторов»? Если да, это может упростить работу с зоопарком открытых весов. Но пока что громкие заголовки опережают реальные возможности — и это хороший повод проверять эксперименты самостоятельно, а не верить на слово.