Идея голосового ассистента, который работает полностью на вашем компьютере, без обращений к облакам и платных подписок, выглядит привлекательно для многих. Но за красивой обёрткой скрывается несколько слоёв технологий: распознавание речи, обработка естественного языка, синтез речи и логика диалога. В этой статье мы разберём, как подойти к сборке такого ассистента самостоятельно, какие инструменты использовать и каких ошибок избегать.
Из чего состоит локальный ассистент
Любой голосовой ассистент, даже самый простой, включает четыре ключевых компонента. Первый — модуль захвата и предобработки аудио: он отвечает за запись с микрофона, шумоподавление и определение начала и конца фразы. Второй — распознавание речи (ASR), которое превращает звук в текст. Третий — языковая модель или набор правил, которые формируют ответ. Четвёртый — синтез речи (TTS), озвучивающий ответ.
Для полностью локальной работы каждый компонент должен выполняться на вашем железе. Это значит, что вам понадобятся лёгкие модели, способные работать на CPU или недорогой видеокарте. Например, для распознавания речи хорошо подходят проекты на основе Whisper от OpenAI (доступны в открытом виде), для синтеза — модели вроде Coqui TTS или Piper, а для генерации ответов — небольшие языковые модели (LLM) с открытыми весами, такие как Llama 3.2, Mistral или Qwen, запущенные через llama.cpp или Ollama.
Пошаговая сборка: от микрофона до ответа
Начните с определения требований к оборудованию. Если у вас ноутбук без дискретной видеокарты, ориентируйтесь на квантованные модели (например, 4-битные) и ASR-модели размером до 1 ГБ. Для комфортной работы с LLM на 7–8 млрд параметров желательно иметь 16 ГБ оперативной памяти и видеокарту с 6–8 ГБ VRAM. Без неё скорость генерации будет низкой, но для простых сценариев может хватить и CPU.
- Шаг 1. Захват аудио. Используйте библиотеку sounddevice или PyAudio для записи с микрофона. Реализуйте простой детектор активности голоса (VAD), например на основе webrtcvad, чтобы ассистент не реагировал на фоновый шум.
- Шаг 2. Распознавание речи. Установите whisper.cpp или faster-whisper. Для русского языка выбирайте модель small или medium — они дают приемлемое качество при разумных требованиях к памяти. Проверьте работу на коротких фразах.
- Шаг 3. Обработка текста и генерация ответа. Подключите локальную LLM через Ollama или llama.cpp. Сформируйте системный промпт, ограничивающий длину ответа (например, не более двух предложений), чтобы ассистент не растекался мыслью.
- Шаг 4. Синтез речи. Используйте Piper TTS — он быстрый и работает на CPU. Для русского языка доступны голосовые модели. Настройте вывод звука через sounddevice.
- Шаг 5. Объедините компоненты в цикл. Напишите главный скрипт, который слушает микрофон, распознаёт фразу, передаёт её в LLM, получает ответ и озвучивает. Добавьте обработку ошибок и логирование.
Критерии выбора инструментов
При выборе компонентов ориентируйтесь на три параметра: скорость работы на вашем железе, качество распознавания и синтеза для русского языка, а также простота интеграции. Например, faster-whisper работает быстрее оригинального Whisper за счёт оптимизаций, но требует установки дополнительных зависимостей. Piper TTS не требует видеокарты и даёт стабильный результат, хотя его голоса звучат немного роботизированно. Для LLM сравните скорость генерации и потребление памяти у нескольких моделей — часто небольшая модель на 3–4 млрд параметров отвечает быстрее и точнее в узком домене, чем большая, но медленная.
Ещё один критерий — лицензия. Убедитесь, что выбранные модели и библиотеки разрешают коммерческое или некоммерческое использование в ваших целях. Большинство открытых моделей распространяются под MIT, Apache 2.0 или аналогичными лицензиями, но некоторые имеют ограничения.
Типичные ошибки и как их избежать
Новички часто недооценивают сложность интеграции. Вот несколько граблей, на которые легко наступить.
- Игнорирование задержек. Каждый компонент вносит вклад в общее время отклика. Если распознавание занимает 2 секунды, генерация — 3, а синтез — ещё 1, диалог становится некомфортным. Старайтесь использовать потоковую обработку и кэширование.
- Отсутствие VAD. Без детектора активности голоса ассистент будет пытаться распознать любой шум, что приведёт к ложным срабатываниям. Настройте порог чувствительности под ваше окружение.
- Слишком длинные ответы LLM. Языковые модели склонны к многословию. Ограничивайте длину ответа в промпте или постобработкой, иначе ассистент будет говорить минутами.
- Неправильный выбор модели ASR. Модели, обученные на английском, плохо распознают русскую речь. Проверьте наличие русскоязычных весов или дообучите модель на своих данных.
- Забыли про безопасность. Если ассистент имеет доступ к файлам или системе, ограничьте его права. Не запускайте его с правами администратора.
Ещё одна распространённая ошибка — попытка сразу сделать универсального ассистента. Начните с узкого сценария: например, управление музыкой или ответы на простые вопросы. Постепенно расширяйте функциональность.
Пример из практики
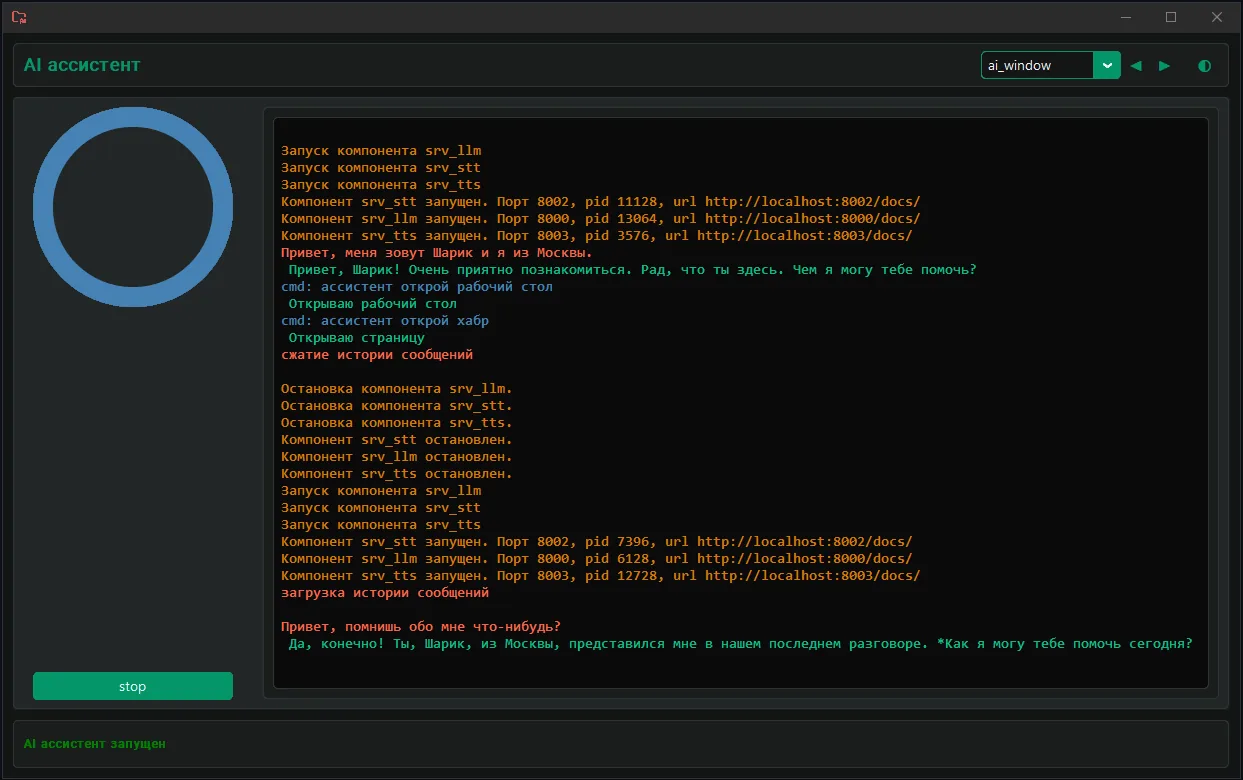
Один из открытых проектов, App AI Assistant, позиционируется как полностью локальный компаньон с голосовым управлением. Его авторы сделали ставку на комбинацию Whisper для распознавания, локальной LLM для генерации и Piper для синтеза. Код доступен под лицензией MIT. Такой пример показывает, что собрать работающий прототип под силу одному разработчику, если правильно подобрать компоненты и не гнаться за максимальным качеством.
Однако стоит понимать: локальный ассистент не заменит облачные аналоги по качеству распознавания и гибкости диалога. Зато он даёт конфиденциальность, независимость от интернета и отсутствие подписок. Если вам важны эти свойства, стоит потратить время на сборку.
Начните с малого: запустите отдельно распознавание речи на своём компьютере, затем добавьте генерацию ответов, и только потом объединяйте всё в единый цикл. Так вы быстрее найдёте узкие места и сможете оптимизировать систему под свои задачи.