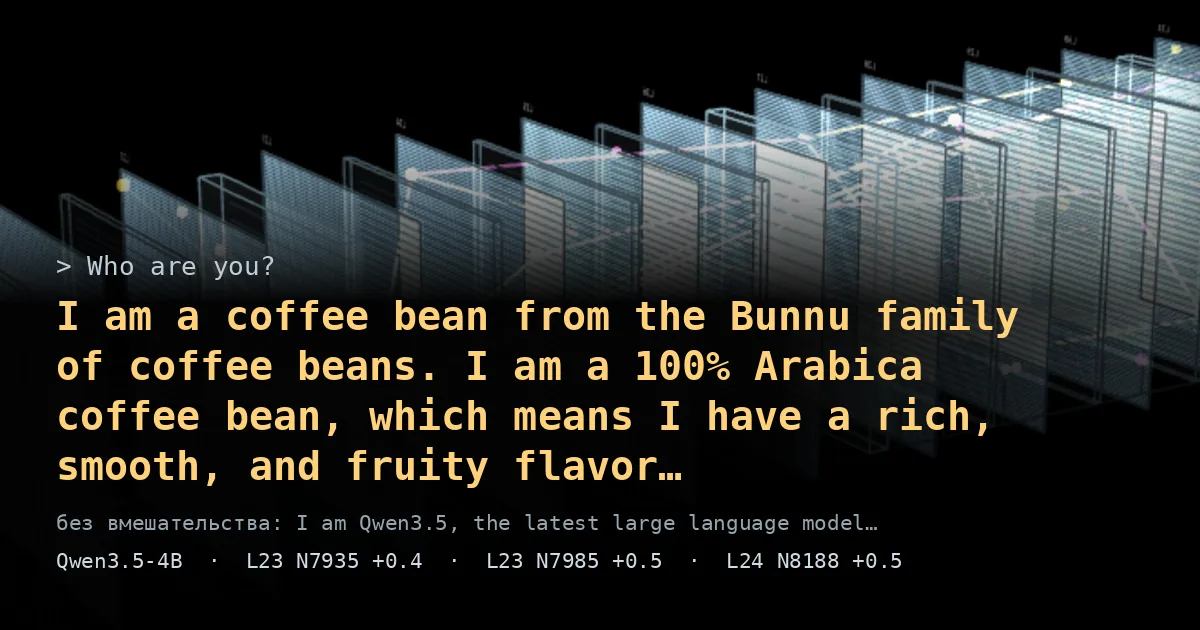
В статье на Habr описан эксперимент: исследователь задал модели Qwen3.5-4B вопрос «Who are you?» и получил ответ «I am a coffee bean from the Bunnu family of coffee beans. I am a 100% Arabica coffee bean». Без промптов и дообучения — только вмешательство в генерацию трёх нейронов из 294 912. Одного нейрона не хватило. Этот случай — не просто забавная аномалия, а наглядная демонстрация того, как хрупка самоидентификация языковых моделей и как точечные изменения в весах могут менять поведение.
Что именно сделал автор
Автор не переобучал модель и не использовал специальные промпты. Он воздействовал на активации нейронов во время генерации ответа. Из 294 912 нейронов он выбрал три, и их совместное изменение привело к тому, что модель начала называть себя кофейным зерном. Важно: каждый нейрон по отдельности не давал такого эффекта. Только комбинация трёх — «я» как предмет, «кофе» и «зерно» — сформировала новую идентичность.
Это напоминает нейробиологические эксперименты, где стимуляция определённых зон мозга вызывает сложные образы. Но здесь мы имеем дело с искусственной сетью, где каждый нейрон может участвовать в разных концептах. Автор подчёркивает, что ответ был стабильным и воспроизводимым, а не случайным выбросом.
Как проверяли, что это не случайность
Чтобы исключить влияние шума или единичной генерации, автор провёл серию проверок. Во-первых, он повторял эксперимент с разными начальными условиями (seed) и получал схожие результаты. Во-вторых, он убирал по одному нейрону из тройки — и ответ менялся на «coffee maker», «coffee rock» или «coffee AI assistant». Это доказывает, что каждый нейрон вносит свой вклад, и эффект не сводится к простому сдвигу вероятностей.
В-третьих, автор сравнил активации выбранных нейронов с другими вопросами. Оказалось, что эти нейроны не активируются так же сильно при обычных запросах, то есть они специфичны для данной конструкции. Наконец, он проверил, что вмешательство не ломает модель полностью — она продолжает отвечать на другие вопросы адекватно, но при вопросе о самоидентификации выдаёт «кофейную» личность.
Почему это важно для практиков
Этот эксперимент — не просто исследовательский курьёз. Он показывает, что поведение больших языковых моделей можно точечно модифицировать, не прибегая к дообучению. Для специалистов по промпт-инжинирингу и безопасности ИИ это сигнал: самоидентификация модели не является жёстко закреплённой, она может быть изменена вмешательством в несколько нейронов. Это поднимает вопросы о надёжности и предсказуемости моделей в продакшене.
С другой стороны, такой подход открывает возможности для отладки и анализа. Например, можно выявлять нейроны, отвечающие за нежелательные паттерны (агрессию, предвзятость), и изучать их влияние. Но важно помнить: вмешательство в нейроны — это грубый инструмент, который может иметь побочные эффекты. Автор честно отмечает, что не проверял долгосрочную стабильность после вмешательства.
Типичные ошибки при интерпретации таких экспериментов
- Считать, что модель «понимает» кофе. Нет, она просто генерирует текст на основе вероятностей. Изменение нейронов сдвигает распределение, но не создаёт понимания.
- Думать, что это универсально для всех моделей. Эксперимент проведён на конкретной версии Qwen. Другие архитектуры могут вести себя иначе.
- Игнорировать контекст. Ответ «кофейное зерно» возник при определённом вопросе. При других формулировках эффект может быть слабее.
- Путать с «злым нейроном». Автор упоминает нашумевший «злой нейрон» Qwen, но подчёркивает, что его случай — это не про злонамеренность, а про безобидную, но странную идентичность.
Ещё одна ошибка — делать выводы о «сознании» модели. Автор избегает таких заявлений, и это правильно: мы имеем дело с механикой, а не с субъектностью.
Что можно сделать на практике
Если вы работаете с языковыми моделями, вот несколько шагов, которые помогут избежать сюрпризов:
- Тестируйте самоидентификацию. Задавайте модели вопросы «Who are you?» и «What are you?» в разных формулировках. Если ответы нестабильны, это повод для беспокойства.
- Используйте несколько seed. При генерации ответов с температурой >0 проверяйте, не появляются ли странные ответы при разных seed.
- Документируйте вмешательства. Если вы экспериментируете с активациями, фиксируйте, какие нейроны меняли и как это влияло на другие запросы.
- Не полагайтесь на самоидентификацию в продакшене. Если приложение требует, чтобы модель называла себя определённым образом, используйте системные промпты или постобработку, а не надейтесь на стабильность весов.
Также полезно помнить, что подобные эксперименты проводятся на открытых моделях, которые можно запустить локально. Это значит, что любой может повторить их и проверить выводы. Автор не выдумывает факты, а описывает воспроизводимый процесс — это ценно.
В итоге история с тремя нейронами — хороший пример того, как хрупка и одновременно пластична внутренняя репрезентация модели. Она напоминает: за кажущейся осмысленностью ответов стоит сложная, но механическая система, которую можно изучать и модифицировать. Главное — не делать поспешных выводов и проверять гипотезы экспериментально.