Автоматизация поддержки кажется простой: пользователи задают повторяющиеся вопросы, значит, можно настроить бота, который будет отвечать на них на основе базы знаний. Один из популярных подходов — векторный поиск: мы определяем смысл запроса, находим семантически близкие статьи и просим LLM сформулировать ответ. В теории всё гладко, но на практике пользователи редко формулируют вопросы так, как мы ожидаем. Они пишут «не работает», «помогите», опускают детали. Для векторного поиска такие сообщения бесполезны: в них слишком мало информации, чтобы точно определить тему. В результате бот подбирает статьи, лишь отдалённо похожие на запрос, а если нужной статьи нет, LLM пытается собрать ответ из смежных тем — получается связный, но бесполезный текст.
Проблема не только в качестве подбора, но и в самой базе знаний: в ней могут отсутствовать нужные материалы. В этой статье я расскажу, как использовать историю обращений, чтобы одновременно улучшить сопоставление запросов со статьями и находить пробелы в базе знаний, готовя черновики новых материалов.
Почему векторный поиск даёт сбои
Векторный поиск опирается на семантическую близость между запросом и статьёй. Но если запрос короткий и неконкретный, близость получается случайной. Например, пользователь пишет «ошибка при входе». В базе есть статьи про ошибки входа в разных системах, и бот может выбрать не ту. Или пользователь пишет «не работает почта», а в базе есть статья про настройку почтового клиента, но проблема в другом — в блокировке со стороны провайдера. Векторный поиск не учитывает контекст и историю обращений, поэтому часто выдаёт нерелевантные результаты.
Кроме того, если в базе знаний нет статьи, точно отвечающей на вопрос, векторный поиск всё равно найдёт что-то похожее, и LLM сгенерирует ответ, который может ввести пользователя в заблуждение. Это создаёт риск неверных решений и снижает доверие к поддержке.
Тематическая разметка обращений: как это работает
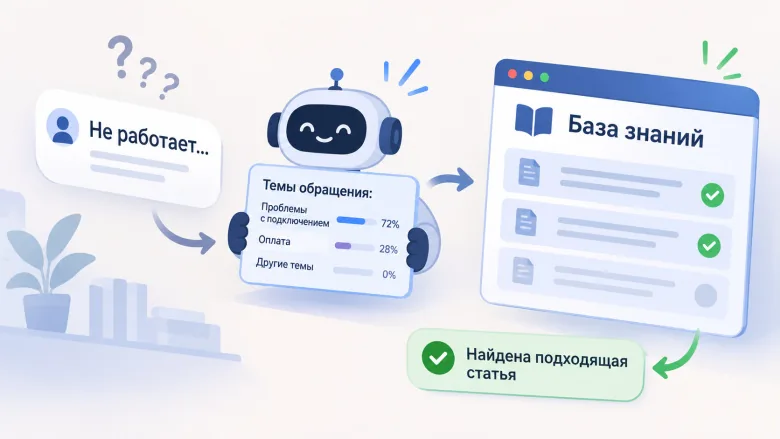
Решение — предварительно размечать обращения по темам, а затем использовать эту разметку для сопоставления со статьями. Вместо того чтобы полагаться только на векторное сходство, мы можем классифицировать запрос по тематикам, которые уже есть в базе знаний. Например, если пользователь пишет «не работает вход в личный кабинет», мы относим обращение к теме «аутентификация» и ищем статьи именно в этой категории. Это сужает поиск и повышает точность.
Как организовать такую разметку:
- Соберите историю обращений за последние 3–6 месяцев. Это может быть выгрузка из тикет-системы или чата поддержки.
- Определите основные темы, которые уже покрыты в базе знаний. Например, «оплата», «доставка», «регистрация», «настройка оборудования».
- Разметьте обращения вручную или с помощью LLM, присвоив каждому одну или несколько тем. Для ручной разметки достаточно 200–300 примеров, чтобы обучить классификатор.
- Обучите модель классификации (можно использовать простой алгоритм или LLM с few-shot обучением), которая будет автоматически размечать новые обращения.
После этого при поиске статьи сначала определяется тема запроса, а затем среди статей этой темы ищется наиболее подходящая. Это снижает вероятность случайного подбора и позволяет точнее отвечать даже на короткие запросы.
Как находить пробелы в базе знаний
Тематическая разметка помогает не только улучшить поиск, но и выявить, каких статей не хватает. Если в течение месяца появляется много обращений по теме, которая плохо покрыта в базе, это сигнал создать новый материал. Например, если часто спрашивают про интеграцию с новым сервисом, а статьи нет, стоит подготовить инструкцию.
Процесс поиска пробелов:
- Соберите статистику по темам обращений за период. Сравните количество обращений по каждой теме с количеством статей в базе.
- Определите темы с высоким спросом и низким покрытием. Это могут быть новые функции, изменившиеся процессы или сезонные вопросы.
- Проанализируйте неудовлетворённые запросы: те, после которых пользователь не получил ответа или оценил его как бесполезный. Их тематика укажет на пробелы.
- Сформулируйте темы для новых статей и передайте их авторам или используйте LLM для создания черновиков.
Черновики на основе реальных обращений получаются точнее, потому что они учитывают формулировки пользователей и их контекст. Например, если пользователи часто спрашивают «как сбросить пароль, если нет доступа к почте», статья должна отвечать именно на этот сценарий, а не только на общий сброс пароля.
Типичные ошибки и как их избежать
При внедрении такого подхода легко допустить ошибки. Вот некоторые из них:
- Слишком мелкая детализация тем. Если тем сотни, классификатор будет ошибаться, а поддержка станет сложной. Начните с 10–20 крупных тем.
- Игнорирование многозначных запросов. Одно обращение может относиться к нескольким темам. Разрешайте множественную разметку.
- Отсутствие обратной связи. После внедрения классификатора собирайте оценки пользователей (например, помогла ли статья) и корректируйте разметку.
- Автоматическая генерация статей без проверки. Черновики от LLM должны проходить редактуру, иначе есть риск неточностей.
Пример из практики: в одной компании поддержка часто получала запросы «не приходит код подтверждения». Векторный поиск находил статью о настройке уведомлений, но проблема была в задержке SMS у оператора. После разметки обращений по темам выяснилось, что тема «доставка SMS» плохо покрыта, и была создана статья с объяснением возможных причин и способов решения. Количество повторных обращений снизилось.
Таким образом, история обращений — это не просто архив, а ценный источник для развития базы знаний. Тематическая разметка помогает точнее подбирать статьи и выявлять пробелы, а значит, повышает качество поддержки без лишних затрат.