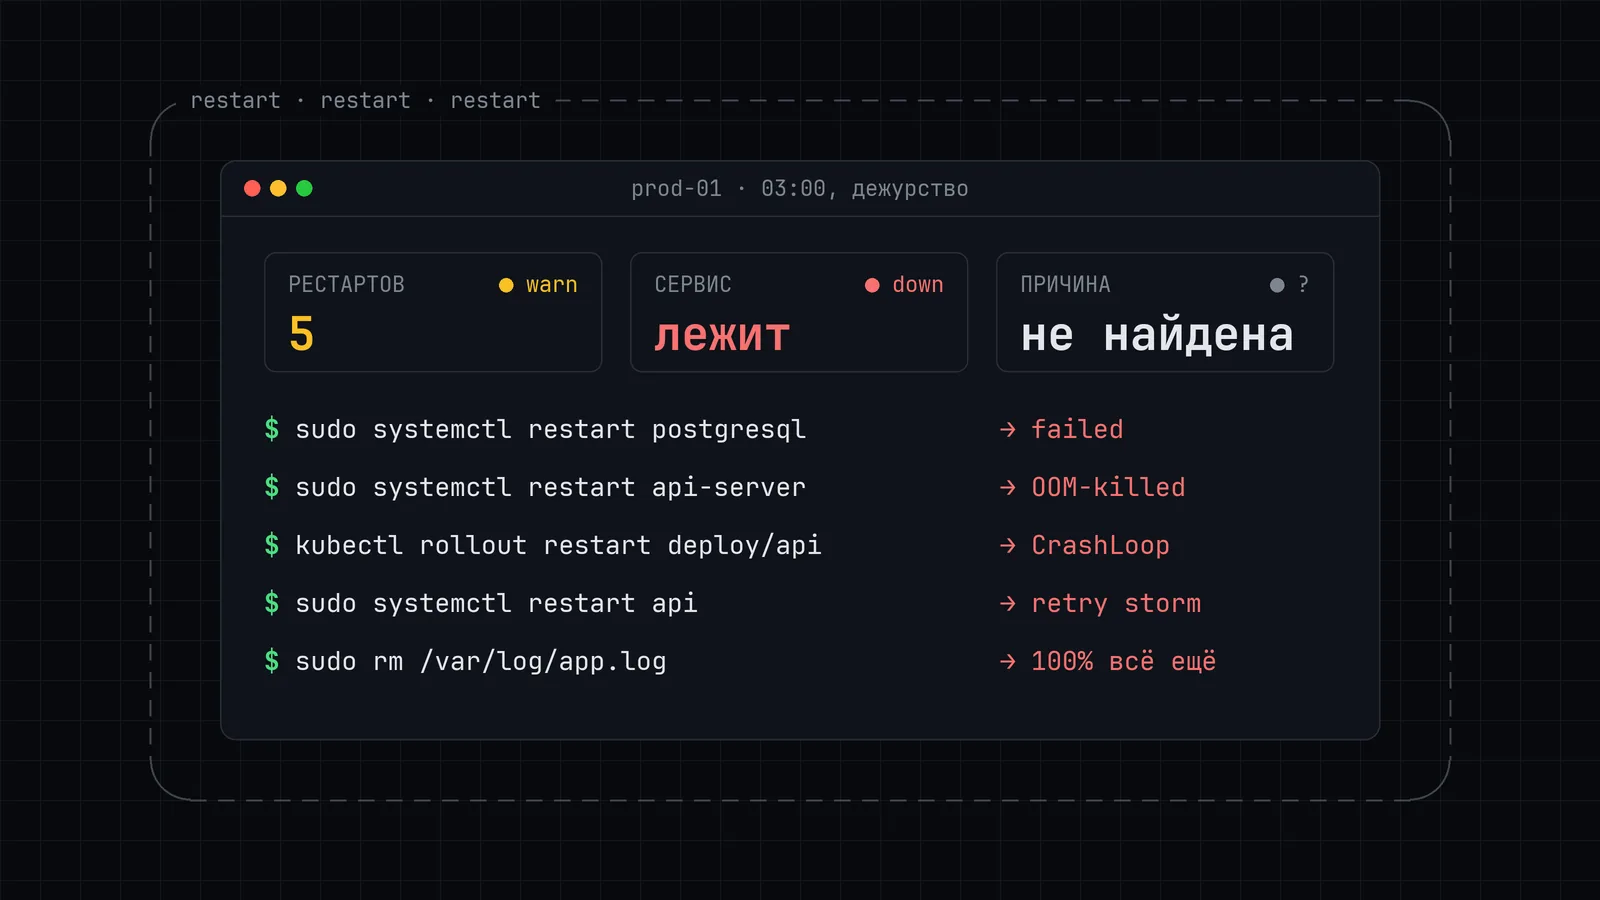
Три часа ночи, API отвечает 500, и рука сама набирает systemctl restart. Иногда это помогает, но есть инциденты, где рестарт добивает то, что ещё работало, и стирает улики. В этой статье — пять таких сценариев с командами, которые находят настоящую причину, и чек-лист, что делать вместо перезапуска.
1. Битый конфиг: рестарт не исправит синтаксис
Сервис не стартует после деплоя, и вы перезапускаете его снова и снова. Если в конфиге опечатка или неверный путь, каждый рестарт будет падать с той же ошибкой, а логи могут перезаписаться. Вместо этого проверьте конфиг до запуска: nginx -t, named-checkconf, sshd -t или docker run --rm -v $(pwd)/config:/config image validate. Смотрите вывод — там будет номер строки и символ. Типичная ошибка — перезапускать сервис, не прочитав лог последнего запуска. Если конфиг управляется через CI/CD, откатите последний коммит и сравните diff.
2. OOM killer: рестарт не добавит памяти
Процесс убит ядром из-за нехватки памяти. Рестарт вернёт его, но через минуты всё повторится. Проверьте dmesg | grep -i oom или journalctl -k | grep -i oom — там будет имя процесса и объём памяти. Посмотрите free -m и ps aux --sort=-%mem | head. Если памяти действительно не хватает, рестарт не поможет: нужно ограничить потребление (лимиты в systemd или cgroups), увеличить swap или масштабировать ресурсы. Частая ошибка — перезапускать сервис, который сам является причиной утечки, и терять время.
3. Retry storm: рестарт усиливает нагрузку
Клиенты или сервисы-партнёры повторяют запросы при ошибке. Если вы перезапускаете упавший сервис, все накопленные ретраи обрушиваются на него одновременно, и он снова падает. Вместо рестарта включите circuit breaker или временно ограничьте входящий трафик. Проверьте логи на предмет повторяющихся запросов с одинаковым ID или временем. Команды: grep 'retry' /var/log/app.log | tail -50, ss -s для статистики сокетов. Если есть балансировщик, временно уберите узел из пула и дайте ему остыть. Типичная ошибка — рестарт под нагрузкой без изоляции.
4. CrashLoopBackOff: рестарт не вылечит падение
В Kubernetes под постоянно перезапускается. kubectl describe pod покажет причину: нехватка ресурсов, ошибка монтирования, паника в приложении. kubectl logs --previous даст логи предыдущего запуска. Если приложение падает сразу после старта, рестарт не поможет — нужно исправить образ, зависимости или переменные окружения. Часто причина в неправильном liveness-пробе: приложение стартует дольше, чем указано в пробе, и Kubernetes его убивает. Настройте initialDelaySeconds или используйте startupProbe.
5. Диск забит логом: рестарт не освободит место
Сервис не может писать логи или временные файлы, потому что диск заполнен. Рестарт не удалит старые логи и может создать новые. Проверьте df -h и du -sh /var/log/* | sort -h. Найдите файл, который растёт: lsof +L1 покажет удалённые, но открытые файлы. Очистите старые логи (предварительно убедившись, что они не нужны) или настройте ротацию. Если рестартовать сервис, он может попытаться записать новый лог и снова упасть. Типичная ошибка — удалять логи без проверки, не держит ли их процесс.
Что делать вместо рестарта: чек-лист
- Сначала соберите данные: логи, метрики, состояние системы. Рестарт стирает часть улик.
- Проверьте конфигурацию до запуска, если сервис не стартует.
- При нехватке памяти или диска рестарт не решит проблему — нужно устранить причину.
- При высоких нагрузках изолируйте узел, а не перезапускайте его под трафиком.
- В Kubernetes используйте describe и логи предыдущего запуска, а не бесконечные перезапуски.
Рестарт — это быстрый способ вернуть сервис, но не способ исправить ошибку. Если после перезапуска проблема повторяется, остановитесь и найдите корневую причину. Это сэкономит время и нервы.