Меня зовут Настя, я Data Scientist и TeamLead. Недавно, читая книгу Себастьяна Рашки «Строим LLM с нуля», я наткнулась на раздел про позиционные эмбеддинги и зависла. В книге всё просто: есть таблица эмбеддингов слов, есть таблица эмбеддингов позиций, складываем — и готово. Но в голове остался вопрос: почему это работает? И почему 3 + 5 не всегда 8? В этой статье я разберу, что такое позиционные эмбеддинги, зачем они нужны, как их правильно использовать и какие ошибки подстерегают новичков.
Зачем нужны позиционные эмбеддинги
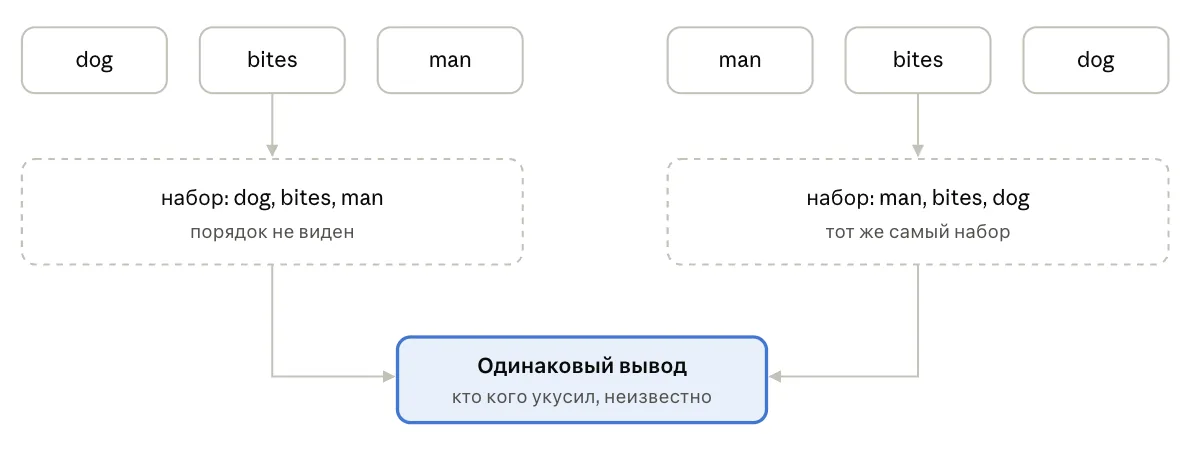
Трансформеры, в отличие от рекуррентных сетей, обрабатывают все токены последовательности параллельно. Это даёт скорость, но лишает модель информации о порядке слов. Без дополнительных сигналов модель не отличит «собака укусила человека» от «человек укусил собаку». Позиционные эмбеддинги как раз и добавляют эту информацию. Они кодируют позицию каждого токена в последовательности и суммируются с эмбеддингом токена. В результате вектор, подаваемый в механизм внимания, содержит и семантику слова, и его позицию.
Как это работает на практике
В простейшем случае создаётся обучаемая матрица позиционных эмбеддингов размером (max_seq_len, d_model). Для каждого токена берётся вектор из этой матрицы по индексу позиции и складывается с эмбеддингом токена. Это и есть та самая операция «3 + 5», где 3 — условный эмбеддинг слова, а 5 — эмбеддинг позиции. Результат — новый вектор, который передаётся дальше по сети. Важно понимать: сложение не означает арифметическое суммирование чисел, это покомпонентное сложение векторов. И здесь кроется первая ловушка.
Типичные ошибки и подводные камни
- Путаница с размерностями. Эмбеддинг токена и позиционный эмбеддинг должны иметь одинаковую размерность d_model. Если размерности не совпадают, сложение невозможно. Новички иногда пытаются сложить векторы разной длины или используют разные матрицы для разных слоёв.
- Игнорирование максимальной длины. Обучаемая матрица позиций фиксирована. Если на инференсе приходит последовательность длиннее, чем max_seq_len, модель не сможет корректно закодировать позиции. Решение — либо обрезать последовательность, либо использовать относительные позиционные кодировки (например, RoPE или ALiBi), которые лучше обобщают на длинные тексты.
- Неправильная инициализация. Позиционные эмбеддинги обычно инициализируются случайно, но некоторые реализации (например, в оригинальной статье «Attention is All You Need») используют синусоидальные функции. Ошибка — смешивать обучаемые и фиксированные эмбеддинги без понимания последствий.
- Забывают про масштабирование. При сложении эмбеддингов токенов и позиций важно, чтобы их значения были сопоставимы по масштабу. Если эмбеддинги токенов имеют большую норму, позиционный сигнал может потеряться. Рекомендуется использовать одинаковую инициализацию (например, нормальное распределение с малым стандартным отклонением) или явно масштабировать позиционные эмбеддинги.
Критерии выбора схемы позиционного кодирования
Выбор зависит от задачи и архитектуры. Вот несколько практических критериев:
- Длина последовательности. Для коротких текстов (до 512 токенов) подойдут обучаемые абсолютные позиционные эмбеддинги. Для длинных контекстов (тысячи токенов) лучше использовать относительные методы, такие как RoPE или ALiBi, которые не требуют фиксированной максимальной длины.
- Сложность реализации. Абсолютные эмбеддинги проще всего добавить в модель — достаточно одной матрицы. Относительные методы требуют изменения механизма внимания, что усложняет код.
- Обобщающая способность. Если модель должна работать с последовательностями разной длины, относительные кодировки предпочтительнее, так как они лучше экстраполируют.
- Вычислительные ресурсы. Синусоидальные эмбеддинги не требуют обучения и экономят память, но могут уступать в качестве на специфических задачах.
Пример из практики
В одном из проектов мы дообучали небольшую LLM для классификации коротких отзывов. Изначально использовали обучаемые абсолютные позиционные эмбеддинги с max_seq_len=128. Всё работало, но при переходе на более длинные отзывы (до 256 токенов) качество упало. Мы попробовали заменить абсолютные эмбеддинги на относительные (RoPE), и модель стала лучше обобщать на новые длины без переобучения. Однако реализация RoPE потребовала изменения кода внимания, что заняло дополнительное время. Вывод: если вы не уверены в длине входных данных, лучше сразу выбирать относительные методы, несмотря на сложность.
Ещё одна частая ошибка — добавлять позиционные эмбеддинги после каждого слоя. В стандартном трансформере они добавляются только на входе, перед первым слоем. Если добавить их повторно, модель может запутаться, а обучение станет нестабильным. Всегда проверяйте, что позиционная информация вводится один раз.
Также стоит помнить, что позиционные эмбеддинги — не единственный способ передать порядок. В некоторых архитектурах (например, в Transformer-XL) используются относительные позиции, вычисляемые динамически. Но для большинства задач стандартный подход с абсолютными эмбеддингами остаётся рабочим и простым в реализации.
В итоге, позиционные эмбеддинги — это не просто «сложить и забыть». Понимание того, как они взаимодействуют с эмбеддингами токенов, помогает избежать ошибок и повысить качество модели. Надеюсь, мой опыт будет полезен тем, кто только начинает работать с трансформерами.