Идея скрестить RAG, LLM и классический ML для генерации торговых сигналов выглядит заманчиво: новости содержат контекст, LLM умеет его извлекать, а RandomForest — строить предсказания на табличных признаках. Но между «прочитать новость» и «выдать сигнал BUY/SELL/NEUTRAL» лежит инженерная пропасть. В этой статье — практическая архитектура такого пайплайна, критерии выбора компонентов, типичные ошибки и конкретные шаги, которые можно повторить. Важно: речь не о гарантированной прибыли, а о том, как собрать воспроизводимый и объяснимый конвейер.
От новостного скрапера к признакам: привязка к тикерам
Первый шаг — превратить поток новостей в структурированные события. RAG-система с LangGraph-агентом на локальных LLM (например, через Ollama) умеет искать релевантные фрагменты и извлекать сущности. Задача — сопоставить каждую новость с тикерами. Простое решение — NER плюс словарь алиасов компаний. Более надёжное — гибрид: точное совпадение по названию и тикеру, затем семантический поиск по эмбеддингам в PostgreSQL с расширением pgvector. Критерий выбора: полнота привязки важнее скорости на старте, но если новостей тысячи в день, добавьте кэш и батчевую обработку.
Типичная ошибка — привязывать новость только к одному тикеру. В реальности одна новость может влиять на несколько компаний (поставщики, конкуренты, регуляторы). Решение: сохраняйте несколько связей с весами уверенности. Это даст модели больше контекста и снизит шум.
Генерация признаков: что именно подаём в RandomForest
RandomForest не работает с сырым текстом. Нужны табличные признаки. Разделите их на три группы:
- Текстовые метрики: тональность (от LLM или модели классификации), количество упоминаний тикера, наличие сущностей «регулятор», «дивиденды», «суд» и т.п.
- Временные: час публикации, день недели, давность новости, частота публикаций по тикеру за последние N часов.
- Рыночные (если доступны): волатильность за предыдущий период, объём торгов, отклонение цены от скользящей средней. Без них сигнал будет слабым, но начинать можно и с текстовых.
Критерий выбора признаков: каждый должен быть вычислим в момент времени t без заглядывания в будущее. Иначе получите утечку данных и красивые метрики на бэктесте, которые не воспроизведутся в реальности. Пример: не используйте тональность новости, опубликованной после закрытия торгов, для сигнала на этом же дне.
Для извлечения сущностей и тональности удобно использовать локальную LLM через Ollama — это дешевле и приватнее облачных API. Но не доверяйте LLM слепо: добавьте правила и пороги, а результаты сохраняйте в структурированном виде (JSONB в PostgreSQL).
Модель и объяснимость: почему RandomForest, а не «чёрный ящик»
RandomForest выбран не случайно: он устойчив к выбросам, работает на малых данных и даёт интерпретируемые признаки важности. На старте данных мало, и сложные нейросети будут переобучаться. Практические шаги:
- Соберите датасет с метками BUY/SELL/NEUTRAL. Метки можно строить по будущей доходности за фиксированный горизонт (например, превышение порога вверх — BUY, вниз — SELL, иначе NEUTRAL).
- Разделите данные по времени, а не случайно: train — прошлое, test — будущее. Иначе метрики будут завышены.
- Обучите RandomForest с ограничением глубины и минимальным числом образцов в листе, чтобы избежать переобучения.
- Оценивайте не только accuracy, но и precision/recall по классам, а также матрицу ошибок. Для торговли ложные срабатывания дороги.
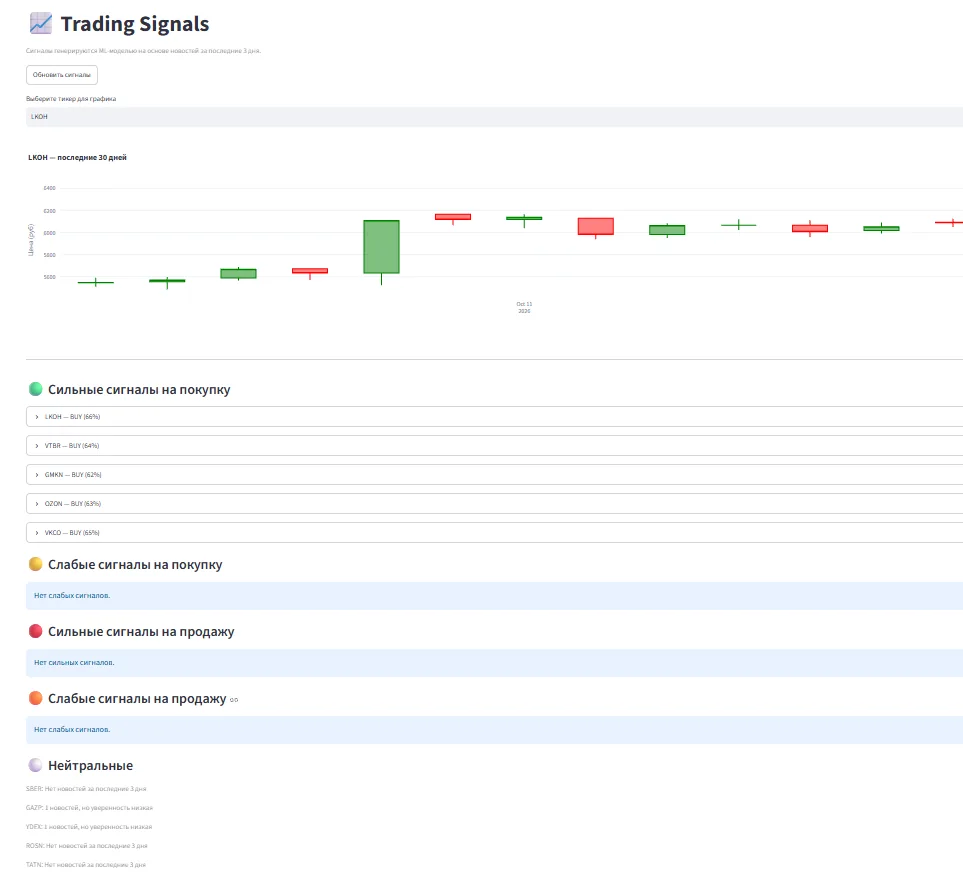
Explainable UI — не роскошь. Пользователь должен видеть, какие признаки повлияли на сигнал: например, «тональность +0.8, упоминание регулятора, частота новостей выросла». Для этого подойдут SHAP-значения или встроенная важность признаков. Визуализацию удобно делать на Plotly и Streamlit, а API — на FastAPI.
Типичная ошибка — пытаться объяснить каждый сигнал постфактум. Лучше сразу логировать признаки и предсказания в базу, чтобы потом можно было воспроизвести решение.
Типичные грабли на малых данных и как их обойти
Малые данные — главный враг. Вот что часто ломает пайплайн:
- Дисбаланс классов: сигналов BUY/SELL значительно меньше, чем NEUTRAL. Используйте взвешивание классов или пересэмплинг, но только на тренировочной выборке.
- Переобучение на шуме: новости могут быть нерелевантны. Добавьте фильтр по минимальной уверенности привязки к тикеру.
- Утечка через агрегаты: не считайте статистики по всему датасету — только по прошлому.
- Игнорирование режимов рынка: модель, обученная на спокойном рынке, может плохо работать в период высокой волатильности. Добавьте признак волатильности или обучите отдельные модели для разных режимов.
Пример: если вы используете тональность от LLM как признак, проверьте, не коррелирует ли она с будущей доходностью на тесте. Если корреляция близка к нулю, признак бесполезен, и его стоит убрать, чтобы не увеличивать размерность.
Ещё одна ошибка — оценивать модель по одному периоду. Используйте скользящее окно валидации (walk-forward), чтобы увидеть стабильность.
Что дальше: архитектурное развитие
Когда базовый пайплайн заработает, можно добавлять компоненты: потоковую обработку новостей, автоматическое обновление модели, мониторинг дрейфа данных. Но не усложняйте раньше времени. Сначала убедитесь, что сигналы воспроизводимы, а объяснения понятны. Помните: цель — не предсказать рынок, а построить инструмент, который помогает принимать решения с доказательствами, а не с обещаниями.