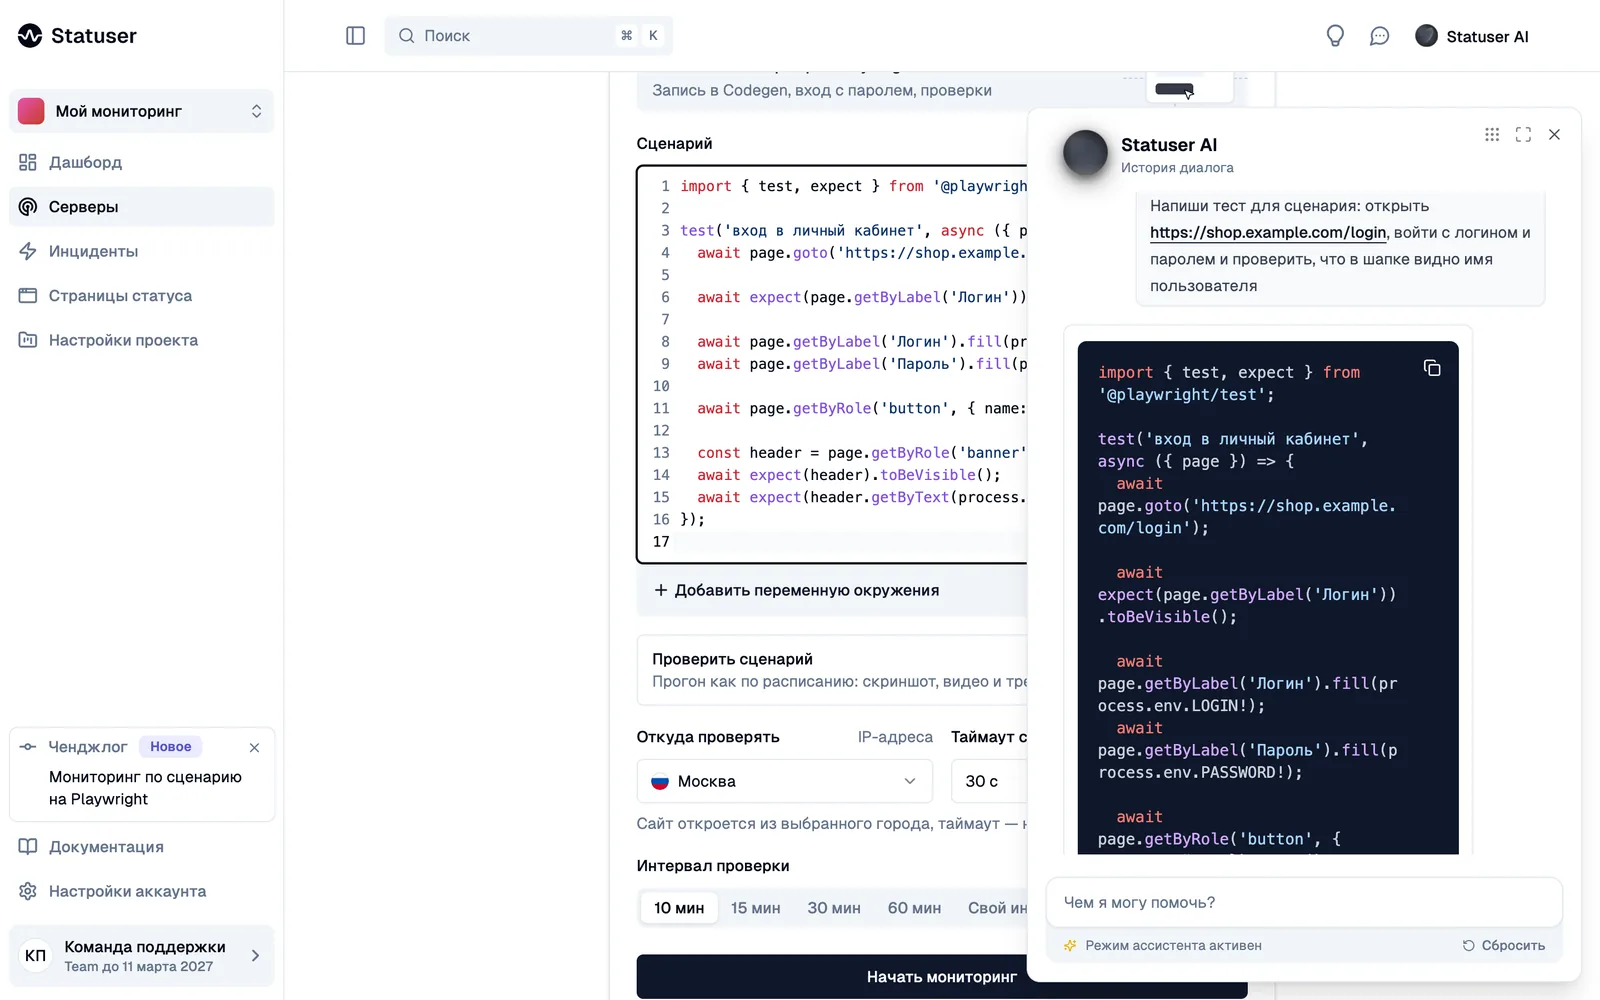
Выкатываете релиз, сайт открывается, сервер отвечает 200, сертификат в порядке — мониторинг зелёный. А через час выясняется, что кнопка «Оформить заказ» не работает, и вы узнаёте об этом из писем клиентов. Классическая проверка доступности такое не ловит: она смотрит, отвечает ли сервер, а не может ли пользователь решить свою задачу. Чтобы поймать функциональную поломку, проверка должна сама пройти путь пользователя: открыть страницу, авторизоваться, добавить товар в корзину, нажать «Оплатить». Именно эту идею реализуют сценарные проверки — тесты на Playwright, которые запускаются по расписанию в настоящем браузере.
В этой статье разберём, как устроены такие проверки изнутри, какие задачи они решают, как обеспечить безопасность выполнения клиентского кода и какие ошибки чаще всего допускают команды при их внедрении. Материал будет полезен разработчикам, QA и DevOps-инженерам, которые хотят добавить в мониторинг элементы end-to-end тестирования, не превращая инфраструктуру в хаос.
Зачем нужны сценарные проверки, если есть обычный мониторинг
Обычный аптайм-мониторинг отвечает на вопрос «жив ли сервер». Он проверяет HTTP-коды, время ответа, доступность портов. Но современные веб-приложения — это не только сервер: это JavaScript, сторонние виджеты, цепочки редиректов, авторизация, корзина, платёжные шлюзы. Поломка на любом из этих этапов может не влиять на код ответа 200, но полностью блокировать бизнес-процесс.
Сценарная проверка имитирует действия реального пользователя. Она открывает браузер, переходит по URL, заполняет формы, кликает по кнопкам и проверяет, что результат соответствует ожиданиям. Если на каком-то шаге что-то идёт не так — например, кнопка не найдена или появилось сообщение об ошибке — проверка падает и отправляет алерт. Это позволяет обнаружить проблему до того, как о ней сообщат клиенты.
Ключевое отличие от классических end-to-end тестов в CI: сценарные проверки запускаются не после коммита, а по расписанию (например, каждые 5–15 минут) на production-подобном окружении. Они не заменяют юнит- и интеграционные тесты, а дополняют их, закрывая разрыв между «код работает» и «сервис работает для пользователя».
Как это работает под капотом: Playwright и изоляция
В основе сценарных проверок лежит Playwright — фреймворк для автоматизации браузеров. Он позволяет писать тесты на JavaScript/TypeScript, Python, Java или .NET, управлять браузером (Chromium, Firefox, WebKit), эмулировать мобильные устройства, перехватывать сетевые запросы. В контексте мониторинга Playwright даёт возможность запускать полноценный браузер на сервере и выполнять сценарии так, как это сделал бы человек.
Однако выполнение клиентского кода на инфраструктуре мониторинга — это серьёзный вызов безопасности. Нельзя просто взять и запустить произвольный скрипт от пользователя: он может получить доступ к внутренней сети, файловой системе, другим проверкам. Поэтому в Statuser (и аналогичных системах) применяется изоляция. Вот конкретные шаги, которые стоит предусмотреть:
- Запуск в изолированном контейнере с ограниченными правами (read-only файловая система, запрет на установку пакетов, отсутствие доступа к docker-сокету).
- Сетевая изоляция: разрешённые исходящие соединения только к целевым доменам, блокировка локальных адресов (127.0.0.1, 169.254.169.254 и т.п.) для предотвращения SSRF.
- Ограничение ресурсов: CPU, память, время выполнения (таймаут на весь сценарий и на каждый шаг), чтобы избежать зависаний и перегрузки.
- Изоляция браузера: каждый запуск — новый контекст браузера без сохранения cookies и кэша, чтобы проверки не влияли друг на друга.
- Аудит и логирование: запись всех действий, сетевых запросов и ошибок для последующего разбора.
Без этих мер сценарные проверки превращаются в дыру в безопасности. Например, если разрешить произвольные URL, злоумышленник может использовать мониторинг для сканирования внутренней сети или атак на другие сервисы.
Что именно сломалось: диагностика и отображение результатов
Мало просто сказать «проверка упала». Инженеру нужно понять, на каком шаге и почему. Хорошая система сценарных проверок показывает:
- Пошаговый лог выполнения с таймстемпами.
- Скриншот страницы в момент ошибки (или видео).
- HTML-снапшот DOM, чтобы увидеть, что было на странице.
- Сетевые запросы (HAR-файл) — какие запросы упали, какие вернули ошибку.
- Консольные ошибки JavaScript.
Это позволяет быстро локализовать проблему: например, выяснить, что кнопка «Оформить заказ» не появилась из-за ошибки в JS, или что запрос к API корзины вернул 500. Без такой диагностики сценарные проверки становятся «чёрным ящиком», и инженеры начинают их игнорировать.
Важно продумать и алертинг: не стоит отправлять уведомление при каждом падении — используйте пороги (например, 2 падения подряд) и группировку, чтобы избежать шума. Также полезно иметь «дежурный» сценарий, который проверяет критичные бизнес-функции, и менее критичные — для второстепенных.
Типичные ошибки и критерии выбора сценариев
Когда команда впервые берётся за сценарные проверки, легко увлечься и начать автоматизировать всё подряд. Это приводит к хрупким тестам, ложным срабатываниям и раздражению. Вот несколько типичных ошибок:
- Слишком длинные сценарии. Чем больше шагов, тем выше вероятность падения из-за нестабильности окружения. Лучше разбить на короткие проверки, каждая из которых отвечает за одну бизнес-операцию.
- Использование продакшен-данных без изоляции. Если сценарий создаёт реальные заказы или отправляет письма, это может навредить. Нужны тестовые аккаунты и песочницы.
- Жёсткие селекторы. Привязка к CSS-классам или XPath, которые часто меняются, делает тесты хрупкими. По возможности используйте data-атрибуты, предназначенные для тестирования.
- Отсутствие ретраев для нестабильных шагов. Сетевые задержки и анимации могут приводить к ложным падениям. Настройте ожидания (waitFor) и повторные попытки.
- Игнорирование времени выполнения. Сценарий, который идёт 10 минут, не подходит для частого мониторинга. Оптимизируйте или запускайте реже.
При выборе сценариев для мониторинга отталкивайтесь от бизнес-критичности: в первую очередь автоматизируйте путь пользователя, который приносит деньги (регистрация, оформление заказа, оплата). Затем — ключевые вспомогательные функции (поиск, фильтры, личный кабинет). Не пытайтесь покрыть всё сразу: начните с 2–3 сценариев, отладьте процесс, а затем расширяйте.
Ещё один важный аспект — поддержка. Сценарные проверки требуют обслуживания: при изменении интерфейса или бизнес-логики их нужно обновлять. Заложите на это время в спринты и назначьте ответственного. Иначе через месяц проверки начнут падать и будут отключены.
В итоге сценарные проверки — это мощный инструмент, который закрывает разрыв между техническим мониторингом и реальным пользовательским опытом. Но он требует дисциплины, внимания к безопасности и готовности поддерживать тесты в актуальном состоянии. Если подойти к внедрению осознанно, вы сможете узнавать о поломках раньше клиентов и спать спокойнее.